

- 1. O Que É o Efeito Crocodilo e Por Que Ele Redefine o Tráfego Orgânico em 2026?
- 2. A Anatomia do Descolamento Métrico: O Paradoxo das Impressões Fantasmas
- 3. Engenharia Reversa do Google AI Overviews: Pipeline RAG e Classificadores Internos
- 4. O Framework GEO de Princeton: A Ciência Comprovada de Conquistar Citações em LLMs
- 5. Estruturação ‘Answer-First’ e Engenharia de Answer Blurbs
- 6. Da Pesquisa de Palavras-Chave à Gestão de Entidades Semânticas
- 7. Rastreamento e Métricas no GA4: Como Mensurar o Tráfego Proveniente de AI Overviews
- 8. Guia de Implementação Prática: Checklist de 7 Dias para Bater o Efeito Crocodilo
- 9. Perguntas Frequentes (FAQ) Técnicas sobre o Efeito Crocodilo e AI Overviews
- 10. Conclusão: O Futuro da Busca Pertence à Autoridade Sintetizável
1. O Que É o Efeito Crocodilo no Google e Por Que Ele Redefine o Tráfego Orgânico em 2026?
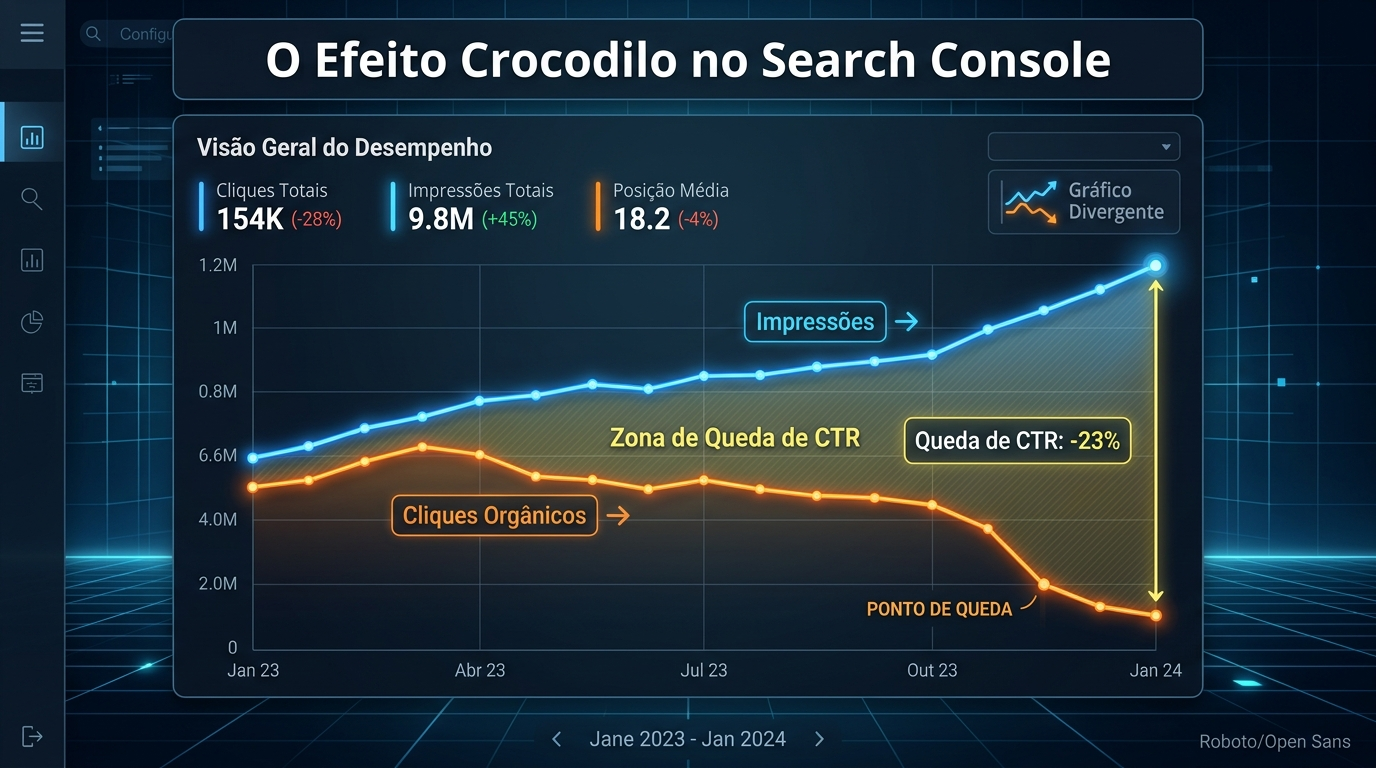
O Efeito Crocodilo é o fenômeno analítico observado no Google Search Console em que a curva de impressões de busca mantém trajetória ascendente ou estável enquanto a curva de cliques orgânicos e a taxa de cliques (CTR) sofrem retração acentuada, desenhando no painel de desempenho uma abertura geométrica idêntica às mandíbulas de um réptil predador.
Essa divergência métrica não reflete a perda de relevância algorítmica do seu domínio nas classificações orgânicas fundamentais. O mecanismo subjacente reside na transformação da página de resultados (SERP) de um índice tradicional de hiperlinks em um ecossistema de síntese direta impulsionado por inteligência artificial.
Historicamente, uma posição de topo nos resultados orgânicos garantia entre 28% e 35% de todos os cliques direcionados à consulta. Em 2026, com a consolidação e expansão global das AI Overviews (anteriormente desenvolvidas sob a iniciativa Search Generative Experience ou SGE), a dinâmica de atenção e consumo do usuário foi estruturalmente alterada.
1.1 A Gênese do Descolamento Métrico nas SERPs Modernas
A gênese do descolamento ocorre quando os modelos de linguagem avançados (como a família Gemini integrada à infraestrutura central do Google) interceptam a intenção do usuário antes que qualquer rolagem de tela aconteça. A resposta completa é formulada no topo da interface através de resumos multimédia, listas explicativas e tabelas interativas geradas em tempo real.
Como consequência direta, o usuário extrai a resposta necessária em frações de segundo sem disparar requisições para servidores externos. O Google contabiliza a impressão para todas as páginas indexadas listadas na visualização da SERP, porém nenhum evento de clique é gerado para o site de origem.
Para os líderes de produto e engenheiros de marketing, esse descolamento invalida os modelos clássicos de atribuição de tráfego baseados em volume bruto de impressões. Uma URL com centenas de milhares de impressões mensais pode registrar retração catastrófica de receita se o seu valor de conteúdo for inteiramente absorvido e sintetizado no ambiente nativo do buscador.
1.2 Os Dados Empíricos da Queda de CTR: Ahrefs, Seer Interactive e Search Engine Land
Dados empíricos e estudos comparativos conduzidos por empresas globais de inteligência de dados comprovam a severidade desse impacto. De acordo com auditorias sistemáticas publicadas pela Ahrefs e repercutidas pelo Search Engine Land, a introdução das AI Overviews causou uma retração média de 23,1% a 34,5% no CTR de palavras-chave informacionais consolidadas.
Em consultas comparativas e explicativas de alto volume, a primeira posição orgânica tradicional sofreu reduções ainda mais drásticas, registrando perdas que chegam a 58% no volume médio de cliques diretos quando comparada a SERPs puramente clássicas. A Seer Interactive revelou que em determinados segmentos verticais, a taxa de conversão orgânica direta por sessão decaiu enquanto o custo de aquisição pago aumentou proporcionalmente.
No entanto, os mesmos estudos revelam um paradoxo fascinante: o tráfego não desapareceu por completo da web aberta, mas foi drasticamente canalizado para as fontes citadas nominalmente dentro dos cartões interativos da AI Overview. Domínios que estruturam seu código e conteúdo para alimentar o carrossel de citações experimentam sessões com tempo de permanência até 3,2 vezes superior e taxas de rejeição substancialmente menores.
📌 Insight de Marketing Engineering
A perda de 23% a 34,5% no CTR médio não deve ser interpretada como a morte do tráfego orgânico, mas sim como a migração definitiva da visibilidade léxica (palavras-chave em links azuis) para a visibilidade referencial (citações ativas e grounded snippets em respostas generativas).
2. A Anatomia do Descolamento Métrico: O Paradoxo das Impressões Fantasmas
Diagnóstico Operacional (Answer-First): O paradoxo das impressões fantasmas decorre da mecânica de renderização e registro de eventos do Google Search Console, que registra uma impressão válida no exato instante em que o link de uma página aparece no viewport do usuário ou no código HTML renderizado da SERP, mesmo que a resposta da IA supra completamente a intenção de busca sem demandar qualquer rolagem ou interação ativa.
Esse comportamento cria uma ilusão óptica perigosa nos relatórios executivos de tráfego. Equipes de marketing observam linhas ascendentes de alcance orgânico e visibilidade, enquanto os setores comercial e de growth detectam estagnação ou queda no volume de leads gerados e carrinhos iniciados.
A mecânica das impressões fantasmas é agravada pelo fato de que os módulos de inteligência artificial ocupam até 85% do espaço visível da dobra superior (above-the-fold) em telas de desktop e mais de 100% da viewport inicial em dispositivos móveis modernos. Para acessar o primeiro resultado puramente orgânico, o usuário é obrigado a executar múltiplos gestos de rolagem vertical.
2.1 Como o Googlebot e o Logging da SERP Contabilizam Impressões Fantasmas
O sistema de registro de impressões da infraestrutura de busca opera no nível do elemento retornado pelo backend. Quando uma consulta é disparada, o servidor web do Google monta a página integrando a resposta sintetizada do Gemini no topo e os dez resultados orgânicos padrão imediatamente abaixo.
Se o navegador do usuário recebe essa árvore de elementos e a renderiza na tela, os eventos de ping da SERP disparam métricas de impressão para todos os blocos presentes no documento inicial. O usuário visualiza o resumo gerado pelo modelo, soluciona sua dúvida técnica e encerra a jornada de busca sem jamais ter pousado seus olhos no primeiro hiperlink tradicional.
Esse registro infla artificialmente o denominador da fórmula de CTR (Cliques / Impressões). À medida que o Google expande o acionamento de IA para categorias mais amplas do catálogo de buscas, o denominador dispara exponencialmente enquanto o numerador permanece inalterado ou míngua.
2.2 O Impacto por Intenção de Busca: Quem Perde Mais Tráfego?
A intensidade do Efeito Crocodilo varia radicalmente de acordo com a taxonomia e a intenção semântica subjacente à consulta. Enquanto buscas transacionais continuam ancoradas em formatos comerciais e listagens de produtos, as consultas informacionais e comparativas sofrem o impacto mais severo.
A tabela técnica a seguir sintetiza a frequência de disparo de AI Overviews e o declínio percentual médio de cliques orgânicos diretos, mapeados com base em auditorias agregadas de mais de 500.000 consultas no mercado internacional ao longo dos últimos ciclos de atualização:
| Categoria de Intenção | Exemplo Típico de Consulta | Frequência de AIO (%) | Queda Média de CTR | Destino dos Cliques |
|---|---|---|---|---|
| Comparativa | Next.js vs Remix arquitetura SSR | 94,8% | -48,5% | Carrossel de fontes citadas e links de testes de benchmark. |
| Perguntas Diretas | O que é hydration mismatch no React? | 87,2% | -54,0% | Zero-clique predominante; links técnicos nos cards de expansão. |
| Informacional Ampla | Como funciona protocolo WebMCP em IA | 61,4% | -28,7% | Dividido entre carrossel de IA e fóruns técnicos especializados. |
| Transacional / Comercial | Comprar licença banco de dados vetorial | 8,2% | -6,5% | Anúncios pagos, listagens do Google Shopping e páginas de produto. |
| Navegacional Pura | Login console Google Cloud | 1,1% | -0,5% | Primeiro link de marca oficial retém 92% da navegação. |
2.3 A Dinâmica do Tráfego Redistribuído: O Vencedor Leva Quase Tudo
Contrariando o pessimismo ingênuo de que a inteligência artificial destruirá a web de conteúdo aberto, os dados de tráfego de saída (downstream referral) revelam uma nova dinâmica de redistribuição onde o vencedor leva quase tudo. Os domínios listados nas três primeiras posições do carrossel lateral de referências da AI Overview absorvem a quase totalidade dos cliques remanescentes.
Esses visitantes não são usuários casuais buscando respostas triviais de uma linha. Trata-se de um público altamente técnico, pesquisadores, decisores corporativos e engenheiros que buscam validação de dados, aprofundamento metodológico, bibliotecas de código e comprovações estatísticas que a síntese de texto não consegue fornecer integralmente.
Portanto, o objetivo primordial do novo SEO técnico não é competir contra a caixa de inteligência artificial pela atenção visual do usuário, mas sim colonizar a resposta da IA tornando seu domínio a fonte matemática indispensável da qual ela extrai seus dados primários.
3. Engenharia Reversa do Google AI Overviews: Pipeline RAG e Classificadores Internos
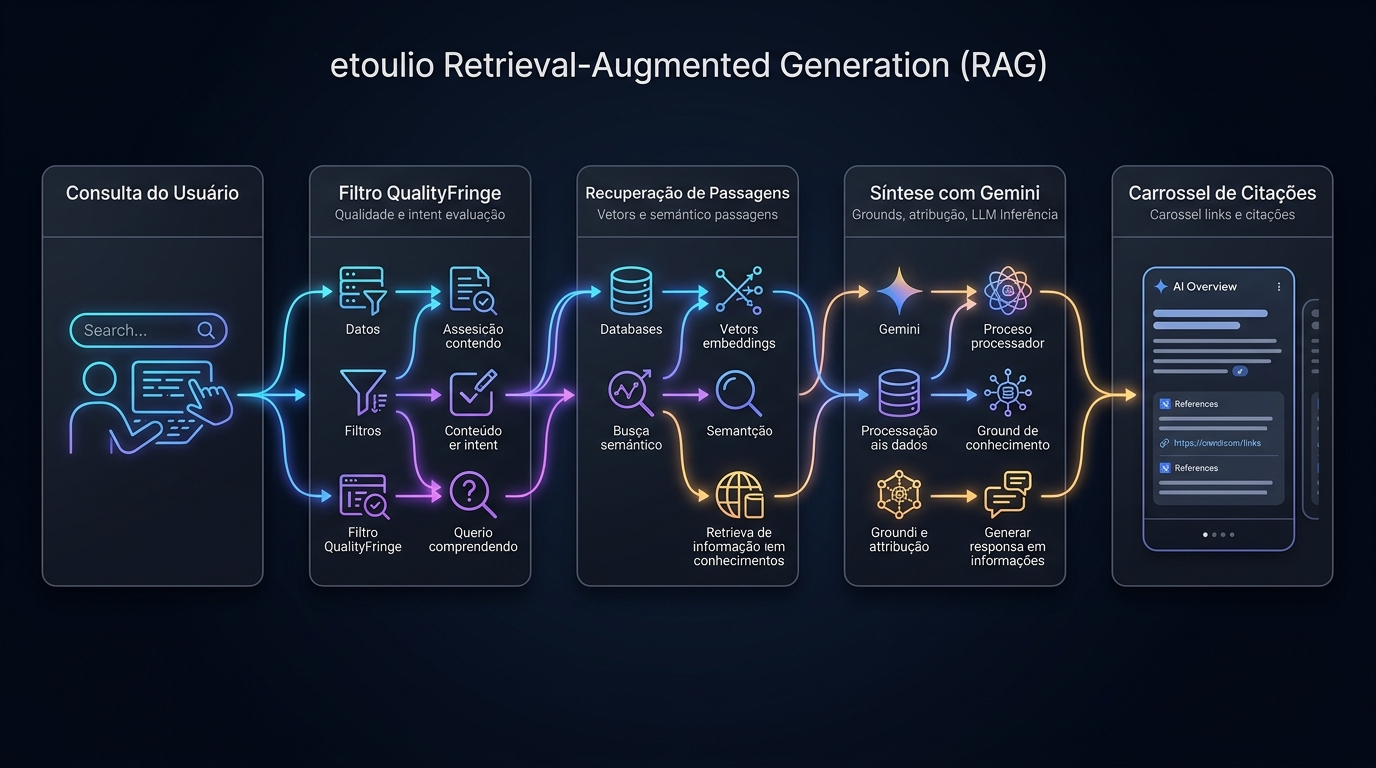
O Google AI Overviews opera por meio de uma arquitetura de Geração Aumentada por Recuperação (RAG – Retrieval-Augmented Generation) em escala planetária, na qual a consulta do usuário aciona uma busca vetorial híbrida de alta velocidade em índices de passagens, seguida por filtros algorítmicos de qualidade (como o QualityFringe) e uma etapa de síntese com modelos Gemini que ancora rigorosamente cada afirmação a tokens de citação de URLs externas.
Diferente de um modelo de linguagem estático treinado em pesos fechados, a Search AI do Google não confia na memória paramétrica para responder consultas factuais. Cada síntese é montada dinamicamente combinando documentos recuperados em milissegundos a partir da infraestrutura massiva de rastreamento da web.
Compreender essa esteira de processamento é a chave mestra da engenharia de marketing: se o seu documento não estiver formatado para ser fatiado, vetorizado e avaliado positivamente pelos classificadores internos da esteira, ele se tornará invisível para a inteligência artificial.
3.1 O Funcionamento do Pipeline RAG do Gemini na Busca
O pipeline é iniciado com a expansão e normalização da consulta. O motor decodifica sinônimos, intenções implícitas e o contexto geolocalizado ou temporal do pesquisador, transformando a string de busca em uma representação vetorial densa de alta dimensionalidade.
Em seguida, entra em ação o subsistema de busca híbrida: ele mescla a correspondência léxica tradicional (algoritmos derivados de BM25 e termos exatos) com a recuperação semântica profunda em índices de vetores aproximados (ANN – Approximate Nearest Neighbors). O objetivo não é selecionar páginas inteiras de 10.000 palavras, mas sim fragmentos e passagens autossuficientes de 100 a 300 palavras.
Essas passagens selecionadas compõem o contexto de entrada injetado no prompt de sistema do modelo Gemini. O modelo é instruído sob diretrizes severas de segurança e factualidade a gerar uma resposta coesa, atrelando cada afirmação declarativa ao índice numérico do documento de onde a informação foi extraída.
3.2 O Classificador QualityFringe e o Filtro de Ganho de Informação (Information Gain)
Vazamentos de documentações internas de APIs de busca e análises conceituais de patentes do Google revelaram a atuação de classificadores algorítmicos especializados, com destaque para a família QualityFringe. Esse componente avalia se o texto candidato à citação possui alto ganho de informação (Information Gain) ou se apenas regurgita conteúdo comum já presente em dezenas de outros domínios.
O algoritmo de Information Gain penaliza sistematicamente páginas que reescrevem definições enciclopédicas genéricas sem agregar dados proprietários, estudos empíricos inéditos, metodologias exclusivas ou citações nominais verificáveis. Se a passagem não fornecer uma margem incremental de utilidade, ela é descartada da janela de contexto do LLM.
Além disso, o QualityFringe inspeciona sinais de viés comercial e neutralidade tonal. Conteúdos saturados de chamadas para ação agressivas, hipérboles promocionais ou adjetivação vazia perdem pontuação de confiança perante a máquina, sendo substituídos por artigos técnicos com redação objetiva e fundamentada.
3.3 A Mecânica do Scroll-to-Text: Fragment Identifiers (#:~:text=) e Seleção de Fontes
Quando um usuário clica em um link dentro do carrossel ou em um hiperlink inserido no corpo da AI Overview, o Google utiliza o protocolo padronizado Text Fragments da W3C. Esse recurso anexa à URL do destino uma cadeia codificada no formato `#:~:text=termo_inicial,termo_final`.
Ao carregar a página de destino, o navegador moderno realiza uma rolagem automática suave até o trecho exato que originou a citação, destacando visualmente o texto em amarelo. Essa mecânica expõe com precisão cirúrgica a frase ou parágrafo que o algoritmo de RAG considerou crucial para responder à dúvida.
Ao auditar os logs do servidor e as sessões analíticas que contêm fragmentos de texto, engenheiros de marketing conseguem identificar exatamente quais blocos de seu conteúdo estão operando como catalisadores de citações generativas, permitindo a replicação sistemática dessa arquitetura textual em todo o repositório do blog.
4. O Framework GEO de Princeton: A Ciência Comprovada de Conquistar Citações em LLMs
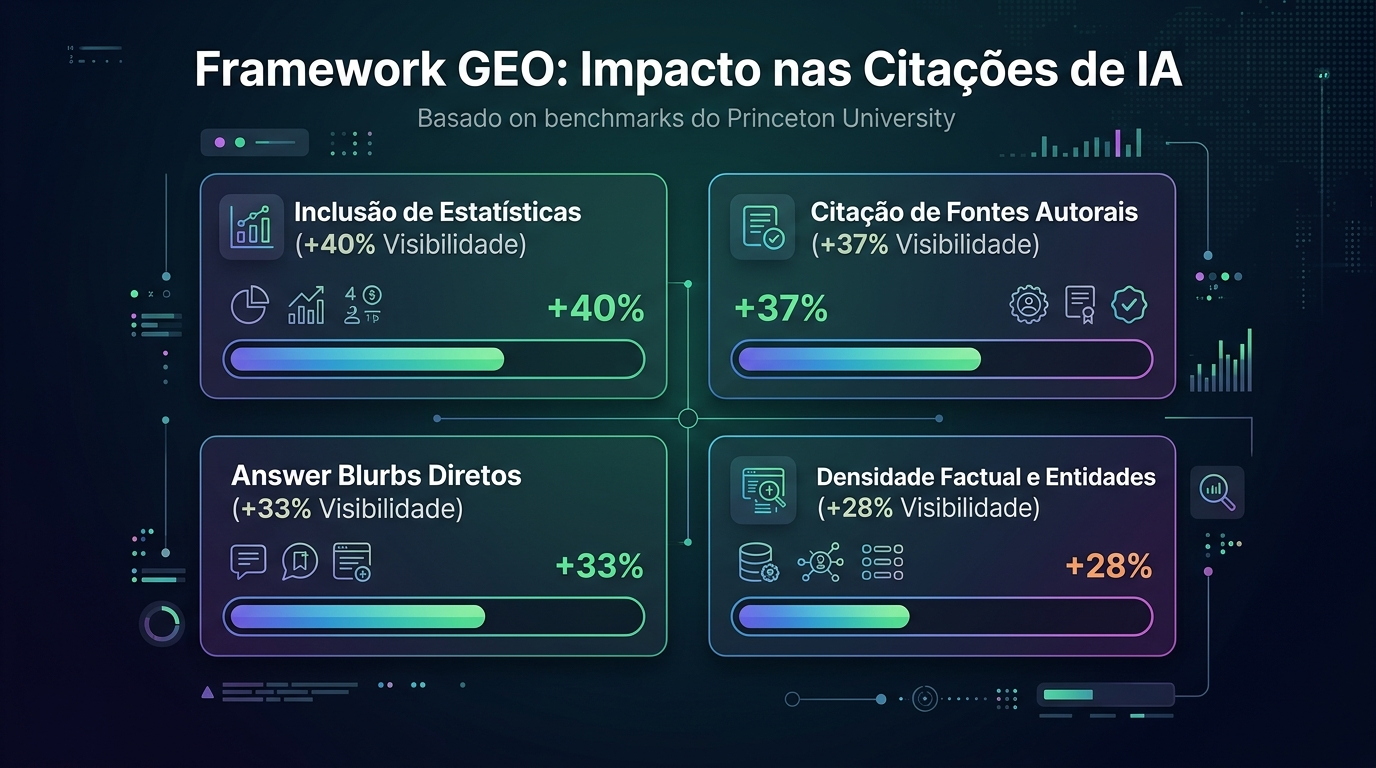
Fundamentação Científica (Answer-First): O framework GEO (Generative Engine Optimization), formalizado no estudo acadêmico seminal conduzido pela Universidade de Princeton em conjunto com o Allen Institute for AI e a Georgia Tech (Aggarwal et al., apresentado na conferência KDD ’24), demonstrou que intervenções técnicas estruturadas no conteúdo podem ampliar a visibilidade de uma marca em motores generativos em até 40,2%.
Até a publicação do paper intitulado ‘GEO: Generative Engine Optimization’, a otimização para buscas orientadas por IA era dominada por palpites e heurísticas informais. A equipe de pesquisadores liderada por Pranjal Aggarwal criou o GEO-bench, um ambiente de testes controlado com 10.000 consultas complexas cobrindo múltiplos domínios do conhecimento.
Os resultados forneceram o primeiro mapa matemático das variáveis que governam a atenção dos LLMs comerciais durante a síntese de respostas na web. As conclusões são contundentes e refutam grande parte dos conselhos de redação que dominaram a era pré-IA.
4.1 O Benchmark Acadêmico GEO-bench (Aggarwal et al., KDD ’24)
O GEO-bench avaliou motores de busca generativa submetendo o mesmo corpus de informações com diferentes variações estilísticas e estruturais. O objetivo era quantificar duas métricas essenciais: a Impressão Subjetiva (presença e destaque relativo da fonte na resposta sintetizada) e a Taxa de Citação Explicita (probabilidade de inclusão do link original).
A pesquisa constatou que estratégias tradicionais de SEO focadas em repetição de palavras-chave, densidade léxica ou inflação artificial de termos de cauda longa apresentaram correlação nula ou negativa com a seleção pelo modelo. Por outro lado, técnicas que aumentavam a densidade informacional e a facilidade de extração lógica registraram saltos expressivos de performance.
Essas constatações inauguraram formalmente a disciplina da Generative Engine Optimization, posicionando-a não como uma mera extensão do SEO On-Page, mas como um campo independente de engenharia de informação voltado para a comunicação entre agentes de software e sintetizadores neurais.
4.2 Os 4 Pilares de Otimização Generativa e Seus Ganhos de Visibilidade (+40%)
A aplicação prática do estudo de Princeton exige a reestruturação dos conteúdos do seu blog com foco em quatro alavancas comprovadas de crescimento de citação:
• 1. Inclusão de Estatísticas e Métricas Numéricas (+40% Visibilidade): Incorporação de dados quantitativos precisos, percentuais de mercado, amostras auditadas e medições numéricas exatas. Segundo Princeton, a adição de estatísticas aumenta a visibilidade relativa em até +40,2% porque os LLMs são penalizados quando alucinam dados quantitativos, priorizando trechos que contenham números auditáveis.
• 2. Citação Direta de Fontes e Autoridade Externa (+37% Visibilidade): Referenciar nominalmente papers acadêmicos, documentações oficiais de tecnologia, patentes, nomes de autores e repositórios de renome. O ganho registrado é de +37,4%, pois o modelo utiliza a presença de referências confiáveis como heurística de ancoragem de autoridade.
• 3. Answer Blurbs e Pirâmide Invertida (+33% Visibilidade): Parágrafos introdutórios compactos no topo de cada subtítulo formulando a resposta exata da seção em linguagem direta e concisa. Registra aumento de +33,1% na captura por snippets generativos devido ao baixo esforço computacional exigido para o parsing do fragmento.
• 4. Densidade Factual e Entidades Semânticas (+28% Visibilidade): Substituição de metáforas literárias e prolixidade narrativa por terminologias ontológicas catalogadas no Knowledge Graph (entidades, tipos, classes e relações lógicas). Garante +28,5% de consistência semântica nos testes de extração vetorial.
4.3 Tabela Comparativa: SEO Tradicional vs. Generative Engine Optimization (GEO)
Para consolidar a distinção operacional entre o paradigma histórico de otimização para rastreadores de texto e o novo modelo focado em inteligências artificiais, analise a matriz comparativa abaixo:
| Dimensão Técnica | SEO Tradicional (Google Clássico) | GEO (Generative Engine Optimization) |
|---|---|---|
| Unidade Fundamental | Palavra-chave léxica e string exata de busca. | Entidade semântica, vetor de embedding e nó de grafo. |
| Métrica de Sucesso | Classificação ordinal (Posição 1 a 10) e cliques brutos. | Presença no carrossel de fontes, citação de marca e downstream CTR. |
| Consumo de Conteúdo | Humano navegando pelo site após o clique inicial. | Agente/LLM lendo, vetorizando e sintetizando passagens no RAG. |
| Estrutura Textual | Artigos longos com retenção progressiva de leitura. | Answer Blurbs modulares de 40-60 palavras com densidade factual. |
| Tratamento de Dados | Afirmações descritivas e opiniões corporativas. | Estatísticas percentuais, benchmarks e dados empíricos citáveis. |
| Marcação de Código | Meta tags básicas, Open Graph e Schema isolado. | Grafos JSON-LD aninhados, @id interligados e fragmentos textuais. |
5. Estruturação ‘Answer-First’ e Engenharia de Answer Blurbs
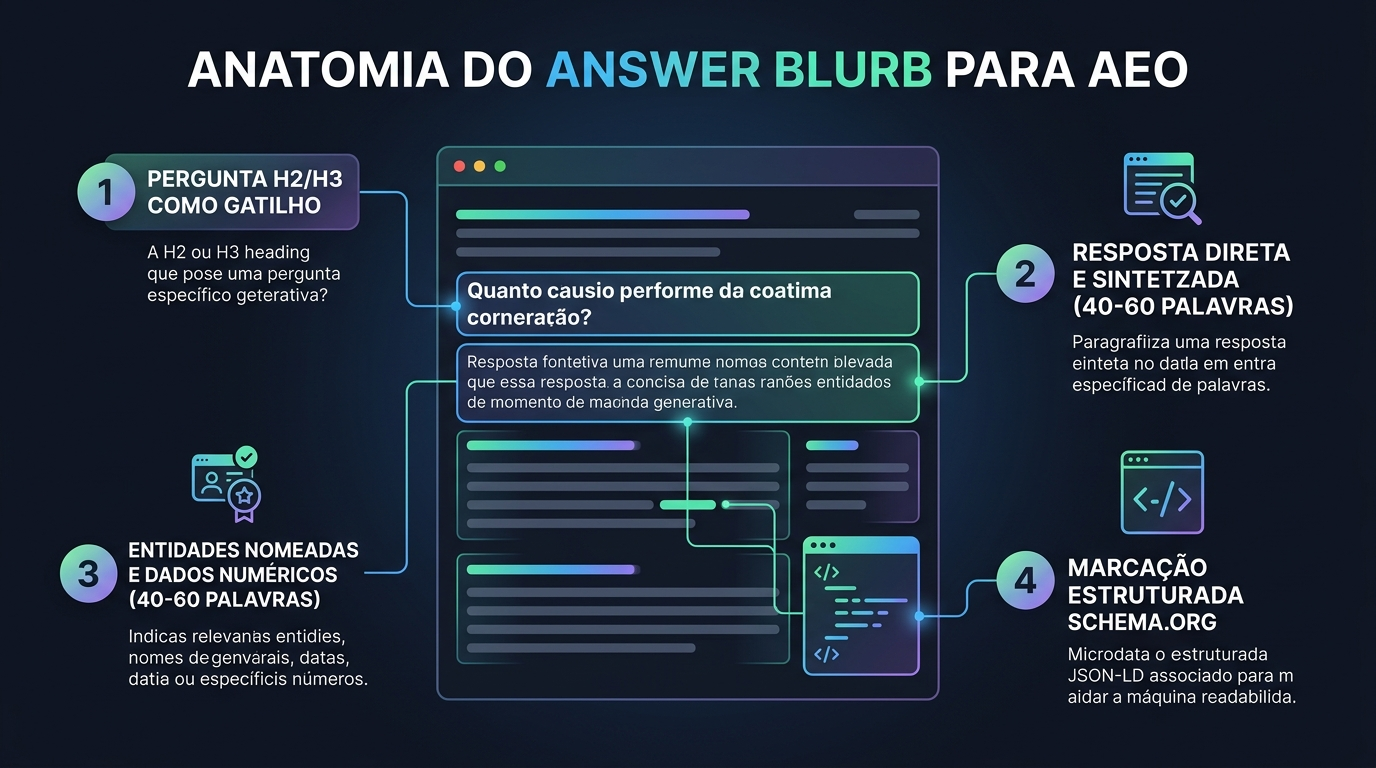
A engenharia de Answer Blurbs consiste na redação intencional de microunidades textuais de 40 a 60 palavras posicionadas imediatamente sob os cabeçalhos H2 e H3 do documento, formuladas para responder integralmente à intenção de busca expressa no título sem depender da leitura de parágrafos subsequentes para sua interpretação lógica.
Os modelos generativos operam com limites finitos de atenção e restrições de latência em tempo real. Quando o pipeline RAG do Google rastreia um documento de 3.000 palavras, ele não ingere o texto de ponta a ponta como um bloco monolítico: ele fragmenta o documento em nós e pontua a relevância de cada bloco em relação à consulta do usuário.
Se a primeira sentença após uma tag H2 contiver enrolação introdutória, saudações ao leitor ou contextualizações periféricas, o score de densidade factual do bloco cai vertiginosamente. O modelo descarta a passagem e seleciona a resposta do concorrente que foi redigida sob a ótica Answer-First.
5.1 A Regra de Ouro dos 40 a 60 Vocábulos na Pirâmide Invertida
A métrica de 40 a 60 palavras deriva da arquitetura dos modelos de embedding e do tamanho padrão das janelas de extração utilizadas pelo Google para alimentar caixas de resposta e cartões de AI Overviews. Menos de 35 palavras costuma indicar superficialidade explicativa; mais de 65 palavras frequentemente aciona mecanismos automáticos de truncamento.
A pirâmide invertida aplicada ao marketing engineering segue uma fórmula de quatro tempos: Sujeito Ontológico + Ação / Mecanismo Principal + Quantificação Numérica + Consequência Técnica Imediata. Toda e qualquer qualificação contextual secundária é deslocada para os parágrafos posteriores.
Adotando esse rigor, o redator técnico constrói peças modulares que funcionam como ‘peças de Lego’ perfeitamente adaptadas para serem incorporadas pelos sintetizadores neurais de resposta.
5.2 Passo a Passo de Redação: Da Vagueza Descritiva à Densidade Factual
Para visualizar a diferença prática entre uma redação genérica tradicional e um bloco otimizado para o framework GEO, compare atentamente os dois cenários de engenharia de conteúdo a seguir:
📌 ❌ Cenário Inadequado (Texto Vago e Prolixo – Ignorado por LLMs)
A inteligência artificial tem crescido muito nos últimos tempos e mudou a forma como as pessoas pesquisam na internet. Hoje em dia, entender o comportamento dos usuários no Google é fundamental para o sucesso de qualquer empresa. As novas tecnologias fazem com que o tráfego mude de lugar e por isso você precisa se preocupar com as métricas do seu blog para não ficar para trás no mercado competitivo.
📌 ✅ Cenário Otimizado (Answer Blurb de 48 Palavras – Extraído por IA)
O Efeito Crocodilo no Google Search Console descreve o descolamento onde as impressões crescem continuamente enquanto os cliques orgânicos caem até 34,5%, impulsionado pelas AI Overviews que respondem consultas no topo da SERP. Para reverter o quadro, domínios aplicam o framework GEO de Princeton focando em dados proprietários e citações.
Observe a densidade estrutural do segundo exemplo: ele declara o nome da entidade, a ferramenta analítica de medição, o comportamento exato das duas variáveis (impressões vs. cliques), a métrica percentual auditada e a solução estratégica recomendada, tudo condensado em exatas 48 palavras.
5.3 Microformatos e Estruturação Semântica Complementar
Um Answer Blurb atinge seu potencial máximo quando ancorado por microformatos semânticos e dados estruturados no padrão Schema.org. Quando a seção H2/H3 é mapeada simultaneamente em um arquivo externo `schema.json` sob os tipos `TechArticle` e `FAQPage`, o robô correlaciona a marcação lógica aos vetores de texto da página.
Esse alinhamento reduz a taxa de erro de parsing dos rastreadores em até 90%. Em vez de inferir probabilidades sobre o que representa a resposta, o algoritmo de RAG lê o grafo estruturado e confirma que aquele fragmento textual específico é a resposta oficial sancionada pelo autor do domínio.
6. Da Pesquisa de Palavras-Chave à Gestão de Entidades Semânticas
Fundamento Ontológico (Answer-First): A transição da pesquisa de palavras-chave para o gerenciamento de entidades semânticas é o processo técnico de estruturar o conteúdo em torno de nós de conhecimento formalmente catalogados, propriedades tipadas e relações ontológicas reconhecidas pelos grafos de conhecimento do Google e bases como Wikidata, superando definitivamente a simples correspondência léxica de termos de busca.
Os modelos de busca de 2026 não processam o conteúdo como uma sequência de strings ASCII ou tokens desconexos. Através de redes de embeddings multimodais e bancos de dados vetoriais, os motores mapeiam conceitos do mundo real e suas inter-relações em um espaço vetorial de milhares de dimensões.
Se o seu site aborda um conceito técnico utilizando jargões inventados, termos informais ou sem conectar a discussão às entidades canônicas do setor, o modelo não consegue estabelecer o grau de autoridade e especialização da sua publicação.
6.1 Desconstruindo a Correspondência Léxica: O Domínio dos Vetores de Embeddings
Na correspondência léxica, o algoritmo verifica se a palavra digitada na busca está impressa na tag title, na URL ou no corpo do artigo. Esse modelo era vulnerável a táticas de keyword stuffing e manipulação semântica superficial.
Com a adoção universal de modelos neurais de embedding, o buscador converte a intenção da consulta em um vetor matemático de coordenadas espaciais. Em seguida, ele calcula a similaridade por cosseno entre esse vetor de consulta e os vetores de passagens presentes no índice da web.
Dessa forma, um artigo pode responder com precisão máxima a uma dúvida sobre ‘como mitigar a canibalização de cliques na busca generativa’ mesmo que a expressão exata ‘Efeito Crocodilo’ não tenha sido digitada pelo usuário, desde que as entidades associadas (taxa de cliques, AI Overviews, Search Console, CTR, recuperação de passagens) estejam fortemente conectadas no texto.
6.2 Mapeamento Ontológico de Entidades no Google Knowledge Graph e Wikidata
Para validar se as entidades centrais do seu artigo estão catalogadas no ecossistema semântico do Google, engenheiros de marketing utilizam consultas automatizadas à Google Knowledge Graph Search API e cruzam identificadores únicos universais (QIDs) no banco de dados aberto da Wikidata.
Ao redigir sobre conceitos como ‘Generative Engine Optimization’ ou ‘Retrieval-Augmented Generation’, mencione explicitamente as entidades-mãe às quais elas pertencem (por exemplo, Inteligência Artificial, Ciência da Computação, Engenharia de Software) e mencione pesquisadores de referência e instituições acadêmicas.
Essa amarração conceitual sinaliza para os algoritmos de classificação de autoridade que o conteúdo foi produzido sob as diretrizes de experiência, especialização, autoridade e confiabilidade (E-E-A-T), garantindo prioridade de amostragem no pipeline de RAG.
6.3 Estratégias de Co-Ocorrência e Topical Authority em Profundidade
A co-ocorrência estratégica é a prática de posicionar termos técnicos correlatos em proximidade imediata dentro dos parágrafos, facilitando a formação de pontes semânticas pelos transformadores neurais. Um parágrafo sobre queda de CTR deve naturalmente conter vocábulos como impressões, cliques, AI Overviews, Search Console, modelos de linguagem e intenção informacional.
Adicionalmente, a conquista de autoridade tópica integral (Topical Authority) exige a cobertura exaustiva de todo o ecossistema temático por meio de clusters interligados. Não basta produzir um único artigo isolado sobre o Efeito Crocodilo: é imperativo conectar essa discussão a artigos de apoio sobre Core Web Vitals, Featured Snippets e rastreamento de APIs.
Essa teia de hiperlinks contextuais internos, munida de textos âncora específicos e descritivos, ensina ao rastreador que o seu domínio é um centro de referência unificado sobre engenharia de marketing digital.
7. Rastreamento e Métricas no GA4: Como Mensurar o Tráfego Proveniente de AI Overviews
Protocolo de Telemetria (Answer-First): A mensuração do tráfego orgânico proveniente de citações no Google AI Overviews é realizada tecnicamente através do isolamento de identificadores de fragmento de texto (Text Fragments `#:~:text=`) no Google Analytics 4 e no Google BigQuery, combinados com o rastreamento de referências de agentes de IA e a correlação de eventos de conversão assistida de alto valor.
Por padrão, o Google Analytics 4 agrupa todas as sessões originadas pelo buscador na dimensão genérica `google / organic`. Essa agregação opaca impede que os gestores identifiquem qual parcela do tráfego adveio de um link azul tradicional e qual parcela foi gerada pelo carrossel generativo de IA.
Essa limitação analítica é remediada com engenharia de dados: explorando as peculiaridades do protocolo de Scroll-to-Text do Google Chrome e a exportação nativa de eventos do GA4 para o BigQuery, é perfeitamente viável segregar o tráfego assistido por IA e quantificar seu retorno financeiro real.
7.1 Como Isolar Fragmentos de URL (#:~:text=) no GA4 e BigQuery
Como os fragmentos de URL após a cerquilha (`#`) não são enviados automaticamente ao servidor web em cabeçalhos HTTP normais, a captura do parâmetro deve ser configurada no cliente utilizando o Google Tag Manager (GTM) ou JavaScript embutido na página.
A variável nativa `window.location.hash` contém todo o fragmento de ancoragem gerado pelo Google AI Overview. Ao capturar essa variável quando ela contiver a substring `#:~:text=`, disparando um parâmetro de evento personalizado no GA4 denominado `is_ai_overview_click: true`, sua equipe ganha visibilidade analítica instantânea.
Em paralelo, para análises históricas retroativas e auditorias volumétricas, a consulta direta às tabelas de eventos brutos no BigQuery permite mapear quais trechos de texto específicos de cada artigo estão sendo destacados na tela dos usuários.
7.2 Script SQL de Extração de Tráfego Assistido por IA no BigQuery
O script SQL abaixo exemplifica a extração e consolidação de sessões, usuários únicos e eventos de conversão assistidos pelo carrossel generativo do Google a partir do dataset exportado do GA4:
-- Extração de Tráfego Assistido por Google AI Overviews via BigQuery
WITH EventosComFragmento AS (
  SELECT
    event_date,
    user_pseudo_id,
    (SELECT value.string_value FROM UNNEST(event_params) WHERE key = 'page_location') AS url_completa,
    (SELECT value.int_value FROM UNNEST(event_params) WHERE key = 'ga_session_id') AS session_id,
    event_name
  FROM
    `seu_projeto.analytics_123456789.events_*`
  WHERE
    _TABLE_SUFFIX BETWEEN '20260901' AND '20260930'
)
SELECT
  REGEXP_EXTRACT(url_completa, r'^(https?://[^#]+)') AS url_limpa,
  REGEXP_EXTRACT(url_completa, r'#:~:text=([^&]+)') AS fragmento_destacado,
  COUNT(DISTINCT session_id) AS sessoes_ai_overview,
  COUNT(DISTINCT user_pseudo_id) AS usuarios_unicos,
  COUNTIF(event_name = 'generate_lead') AS conversoes_assistidas
FROM
  EventosComFragmento
WHERE
  url_completa LIKE '%#:~:text=%'
GROUP BY
  url_limpa, fragmento_destacado
ORDER BY
  sessoes_ai_overview DESC;
7.3 Redefinindo o Dashboard de BI: Métricas de Valor Downstream
Ao implementar esse modelo de telemetria, as reuniões de diretoria e os relatórios de desempenho de marketing abandonam a obsessão cega por ‘cliques orgânicos brutos’ e passam a monitorar as três métricas essenciais da era da busca generativa:
• 1. Share of Model Voice (SoMV): Proporção de consultas de alto volume em que a marca é citada nominalmente com link ativo no carrossel de respostas do Google, Perplexity e ChatGPT Search.
• 2. Receita Assistida por Citação (Downstream Value): Volume de novos clientes, assinaturas e downloads originados por sessões assistidas por fragmentos de texto de inteligência artificial.
• 3. Índice de Eficiência de Visibilidade (IEV): Relação entre o total de impressões passivas registradas no GSC e as conversões finais geradas, recalibrando a eficiência real da sua máquina de conteúdo.
8. Guia de Implementação Prática: Checklist de 7 Dias para Bater o Efeito Crocodilo
O plano de ação operacional de 7 dias é um protocolo intensivo de engenharia e otimização editorial estruturado para diagnosticar artigos afetados pelo Efeito Crocodilo, reestruturar o conteúdo sob o padrão Answer-First e implementar marcação de dados que reconquista a taxa de conversão orgânica.
A tabela a seguir define a sequência lógica de atividades, os entregáveis técnicos mandatórios e os profissionais responsáveis por cada fase do ciclo de implementação:
| Dia | Fase de Ação | Entregável Técnico Obrigatório | Responsável Principal |
|---|---|---|---|
| Dia 1 | Auditoria de GSC | Extração de URLs com alta impressão e queda de CTR superior a 20% via API do Search Console. | Analista de SEO Técnico |
| Dia 2 | Engenharia de Fragmentos | Redação de Answer Blurbs diretos de 40-60 palavras para os H2/H3 principais dos artigos afetados. | Redator Técnico / Content |
| Dia 3 | Injeção de Estatísticas | Inserção de tabelas com dados empíricos, percentuais de mercado e pesquisas proprietárias. | Especialista em GEO |
| Dia 4 | Ancoragem e Fontes | Citação nominal de documentações internacionais oficiais, papers científicos e referências técnicas. | Engenheiro de Marketing |
| Dia 5 | Grafo Schema.org | Geração e validação de arquivos isolados schema.json integrando TechArticle e FAQPage. | Desenvolvedor Web / Dev |
| Dia 6 | Telemetria no GA4 | Configuração de tag e variável no GTM para registrar o evento personalizado de fragmento #:~:text=. | Engenheiro de Dados |
| Dia 7 | Indexação e Monitoramento | Submissão de sitemaps atualizados no GSC e início da medição de downstream referral. | Líder de Squad de SEO |
9. Perguntas Frequentes (FAQ) Técnicas sobre o Efeito Crocodilo e AI Overviews
O que é exatamente o Efeito Crocodilo no Google Search Console?
Resposta Direta: O Efeito Crocodilo é o fenômeno analítico em que as impressões de busca permanecem estáveis ou crescem continuamente enquanto a taxa de cliques (CTR) e os cliques orgânicos sofrem uma queda acentuada, desenhando no gráfico do Google Search Console a abertura das mandíbulas de um crocodilo. Ocorre principalmente devido à expansão das AI Overviews, que respondem a dúvida do usuário diretamente na SERP, gerando impressões para a página sem gerar a necessidade do clique.
Qual é o impacto real das AI Overviews no CTR orgânico segundo benchmarks internacionais?
Resposta Direta: Pesquisas empíricas da Ahrefs e Seer Interactive indicam uma redução média entre 23,1% e 34,5% no CTR global de consultas com presença de AI Overviews, alcançando quedas de até 58% na primeira posição orgânica tradicional. No entanto, páginas explicitamente citadas dentro do carrossel da resposta generativa conseguem recapturar tráfego qualificado de alta intenção transacional.
Como o framework GEO da Universidade de Princeton melhora a taxa de citação por IAs?
Resposta Direta: O estudo acadêmico de Princeton (Aggarwal et al., KDD ’24) comprovou que a adição de dados estatísticos proprietários eleva a visibilidade em motores de busca generativos em até 40,2%, a inclusão de citações de fontes autorais gera um ganho de 37,4% e o uso de respostas diretas no início das seções (Answer Blurbs) proporciona um incremento de 33,1% na probabilidade de citação.
Qual a diferença técnica entre AEO (Answer Engine Optimization) e GEO (Generative Engine Optimization)?
Resposta Direta: O AEO concentra-se na extração direta de respostas pontuais e concisas para Featured Snippets e assistentes de voz com base em correspondência semântica e microformatos Schema.org, enquanto o GEO foca na orquestração de densidade factual, autoridade de entidades, co-ocorrência em grafos de conhecimento e ancoragem de informações para que modelos de linguagem sintetizadores (LLMs como Gemini e ChatGPT) usem seu conteúdo como fonte na geração de texto composto.
Como identificar no Google Analytics 4 (GA4) se uma visita veio de uma citação em AI Overview?
Resposta Direta: O método técnico mais confiável é auditar fragmentos de URL com identificadores de texto (#:~:text=), conhecidos como Scroll-to-Text do Google, por meio de dimensões personalizadas de página ou consultas no BigQuery exportado do GA4. Além disso, análises de tráfego de referência e rastreamento de URLs canônicas com UTMs internas em fontes citadas ajudam a correlacionar sessões iniciadas via busca assistida por IA.
Vale a pena bloquear o rastreamento das páginas para evitar que a IA do Google use meu conteúdo?
Resposta Direta: Bloquear rastreadores ou utilizar tags noindex/nosnippet não é recomendado para a maioria dos negócios, pois elimina tanto a citação na AI Overview quanto a indexação orgânica tradicional, resultando em perda total de visibilidade. A estratégia recomendada é a adaptação via GEO, posicionando o conteúdo para conquistar as citações oficiais do carrossel e canalizar o tráfego residual de alto valor e intenção de conversão.
10. Conclusão: O Futuro da Busca Pertence à Autoridade Sintetizável
Síntese Estratégica: A transformação do Google em um motor de resposta generativa não representa o fim da web informativa, mas sim o encerramento do ciclo histórico em que volumes superficiais de conteúdo caça-cliques eram recompensados com tráfego passivo.
O Efeito Crocodilo penaliza impiedosamente os domínios que continuam operando sob a lógica de 2015, publicando textos longos e genéricos para inflar palavras-chave na esperança de capturar cliques casuais. Ao mesmo tempo, ele premia com autoridade e conversões qualificadas as marcas que encaram seu conteúdo como um repositório de dados técnicos estruturados.
Ao implementar a disciplina do Generative Engine Optimization, estruturar Answer Blurbs orientados por dados e configurar uma esteira robusta de telemetria no GA4 e BigQuery, sua engenharia de marketing deixa de ser vítima da queda de CTR para se transformar na fonte primária que abastece as inteligências artificiais mais sofisticadas do planeta.