O que você vai aprender:
Automação de SEO com Python: Como Auditar Desindexação em Massa e Status Real via Search Console API
1. O Dilema da Desindexação Silenciosa e a Cegueira dos Relatórios Agregados
A automação de SEO com Python tornou-se uma disciplina mandatória para qualquer equipe que gerencia domínios com milhares de páginas indexadas. A desindexação silenciosa de páginas comerciais e conteúdos estratégicos é uma das anomalias mais danosas e difíceis de rastrear em operações digitais de grande porte.
Quando centenas ou milhares de URLs sofrem purga algorítmica do índice do Google, o tráfego orgânico despenca sem que nenhuma notificação explícita seja emitida no painel corporativo. A maioria dos times de produto descobre perdas catastróficas apenas semanas após o incidente, frequentemente alertada por desvios bruscos no faturamento da empresa.
Esse atraso diagnóstico decorre da dependência crônica de relatórios agregados e auditorias visuais manuais no navegador. Compreender como o Google Search Console armazena, atualiza e reporta o status de cada entidade é a chave para antecipar desastres e implementar protocolos de recuperação imediatos.
1.1 Limitações da Interface Web: Amostragem e Latência Temporal
A interface gráfica do Google Search Console impõe uma limitação severa de visualização, restringindo a exibição de tabelas de cobertura a uma amostra máxima de 1.000 URLs por status. Para portais de e-commerce, diretórios imobiliários ou plataformas de publicações técnicas com 50.000 URLs, examinar apenas mil linhas equivale a analisar menos de 2% do ecossistema real.
Além do truncamento amostral, o relatório de Indexação de Páginas apresenta uma latência temporal crônica que varia entre 48 e 96 horas em relação ao estado efetivo dos servidores. Alterações críticas introduzidas em deploys de produção na sexta-feira frequentemente só se manifestam nos gráficos agregados na terça-feira seguinte, acumulando dias de perda de receita invisível.
Essa defasagem temporal transforma a auditoria manual em uma autópsia tardia, em vez de um monitoramento proativo em tempo real. Apenas a consulta programática direta aos pontos de extremidade da API permite auditar o catálogo integralmente, rompendo a barreira do teto de mil URLs.
1.2 O Caso Forense Glenn Gabe: O Mistério dos Arquivos e Diretórios Desindexados
Em setembro de 2026, o renomado especialista em SEO técnico Glenn Gabe (GSQi) documentou um fenômeno alarmante envolvendo a desindexação massiva e súbita de arquivos PDF e seções de documentação técnica. Após ajustes algorítmicos em sistemas centrais de qualidade do Google, websites corporativos perderam repentinamente centenas de documentos de alto ranqueamento que geravam leads qualificados há anos.
Ao investigar o incidente, Gabe constatou que os arquivos não haviam sido bloqueados por robots.txt nem removidos do servidor com código HTTP 404. O Googlebot havia reclassificado esses recursos silenciosamente para a categoria ‘Rastreada – atualmente não indexada’ (Crawled – currently not indexed), sem nenhum aviso no painel de Mensagens.
O desafio central da equipe técnica foi isolar exatamente quais arquivos haviam sido expurgados e quando a desindexação ocorreu entre um repositório com mais de 10.000 PDFs. A resolução rápida do mistério só se tornou viável mediante o cruzamento da Search Analytics API com a URL Inspection API, comprovando que a automação em script é indispensável para diagnósticos forenses modernos.
1.3 Por Que Operadores de Busca (site: e info:) São Inadequados em Larga Escala
Muitos profissionais ainda recorrem a comandos avançados no campo de busca do Google, como ‘site:exemplo.com/url’ ou ‘info:’, acreditando obter uma confirmação definitiva de indexação. No entanto, o próprio Google Search Central já esclareceu que a resposta dos operadores de busca reflete índices intermediários e mecanismos de cache com fortes inconsistências entre data centers.
Uma página pode perfeitamente aparecer em uma consulta com operador ‘site:’ enquanto já está excluída dos resultados de busca orgânica para consultas reais de usuários. Da mesma forma, o operador pode omitir URLs indexadas ativas devido a mecanismos de desduplicação aplicados em nível de apresentação na SERP.
Adicionalmente, executar scraping de comandos ‘site:’ viola frontalmente os Termos de Serviço do Google, disparando CAPTCHAs e bloqueios temporários de endereço IP. A URL Inspection API é a única fonte oficial, autorizada e determinística para extrair a verdade algorítmica sobre a situação de cada documento.
📌 Regra de Ouro da Confiabilidade de Dados de SEO
Nunca tome decisões arquiteturais ou de migração baseado em amostras da interface gráfica do GSC ou em consultas manuais com operadores de busca. A verdade canônica de indexação reside exclusivamente no endpoint da URL Inspection API, que reflete o banco de dados interno de rastreamento do Googlebot sem filtros de apresentação.
2. Anatomia Técnica da Google Search Console URL Inspection API
A URL Inspection API é uma extensão de alto desempenho da Google Search Console API projetada para consultar o estado individual de URLs diretamente na base do Googlebot. Diferente da Search Analytics API, que agrega cliques e impressões de termos de busca, a API de Inspeção fornece uma radiografia técnica e semântica completa de cada documento.
Com um único comando HTTP, o desenvolvedor obtém respostas detalhadas sobre autorização de rastreamento, status de renderização móvel, veredito de dados estruturados e seleção de canônica. Essa granularidade permite correlacionar métricas de cobertura diretamente com parâmetros de infraestrutura, arquivos de log do servidor e esteiras de integração contínua.
2.1 Especificações do Endpoint index:inspect e Payload de Requisição
A consulta de inspeção de URLs é realizada através de uma requisição HTTP POST direcionada ao endpoint oficial da API: ‘https://searchconsole.googleapis.com/v1/urlInspection/index:inspect’. A chamada exige autenticação OAuth 2.0 com escopos de leitura ou gerenciamento do Search Console.
O corpo da mensagem deve ser formatado em JSON contendo três propriedades principais: ‘inspectionUrl’, ‘siteUrl’ e ‘languageCode’ opcional. O parâmetro ‘siteUrl’ deve corresponder com precisão à definição da propriedade cadastrada no Search Console, respeitando a notação de Domínio (‘sc-domain:exemplo.com’) ou Prefixo de URL (‘https://exemplo.com/’).
Abaixo está ilustrado o formato canônico da carga útil JSON necessária para inspecionar uma página técnica corporativa:
# [JSON PAYLOAD]
{
  "inspectionUrl": "https://www.exemplo.com.br/artigos/engenharia-seo-python",
  "siteUrl": "sc-domain:exemplo.com.br",
  "languageCode": "pt-BR"
}
2.2 Inspeção de Índice Armazenado versus Teste ao Vivo
Uma distinção técnica fundamental que todo engenheiro de SEO deve compreender é a natureza do endpoint ‘index:inspect’: ele consulta exclusivamente o Stored Index (índice armazenado). Isso significa que a chamada retorna o estado em que a URL se encontrava na última ocasião em que o Googlebot visitou e processou a página na web.
Diferente da função ‘Testar URL ao vivo’ disponível no botão manual da interface do GSC, a API não renderiza o HTML em tempo de execução nem faz requisições imediatas ao servidor de hospedagem. Essa característica é uma imensa vantagem arquitetural: a consulta não consome recursos de computação do seu backend, permitindo auditar milhares de URLs sem elevar o consumo de CPU.
Entretanto, essa particularidade também impõe uma consideração analítica importante: correções recentes de código não refletirão imediatamente na API. Para validar se uma correção surtiu efeito no índice armazenado, é necessário monitorar o campo ‘lastCrawlTime’ para certificar-se de que o rastreamento ocorreu após a publicação do patch.
2.3 Decodificação do Payload de Resposta e Vereditos de Cobertura
A resposta enviada pelo Google vem envelopada no objeto ‘inspectionResult’, que abriga sub-objetos dedicados ao status de indexação, compatibilidade móvel e dados estruturados. O núcleo essencial para auditorias técnicas reside no nó ‘indexStatusResult’, cujos atributos revelam minuciosamente as decisões algorítmicas tomadas sobre a página.
O atributo ‘verdict’ oferece a avaliação executiva sumarizada do recurso, podendo assumir os valores ‘PASS’ (indexada sem falhas), ‘FAIL’ (não indexada ou com erro impeditivo), ‘PARTIAL’ ou ‘NEUTRAL’. No entanto, para fins de engenharia forense, o campo mais valioso é ‘coverageState’, que descreve textualmente o motivo exato pelo qual a URL está ou não presente no índice.
A tabela a seguir consolida os principais atributos retornados no ‘indexStatusResult’ e suas respectivas responsabilidades diagnósticas:
| Campo JSON | Tipo de Dado | Descrição Técnica | Valores Possíveis Exemplares |
|---|---|---|---|
| verdict | String | Avaliação algorítmica sumarizada do status de indexação da página | PASS, FAIL, PARTIAL, NEUTRAL |
| coverageState | String | Estado canônico de cobertura atribuído pelos sistemas do Google | Submitted and indexed, Crawled – currently not indexed, Soft 404 |
| indexingState | String | Indica se o rastreador possui autorização legal para indexar o recurso | INDEXING_ALLOWED, BLOCKED_BY_META_TAG, BLOCKED_BY_HTTP_HEADER |
| robotsTxtState | String | Validação de conformidade das regras declaradas no arquivo robots.txt | ALLOWED, DISALLOWED |
| pageFetchState | String | Resultado da requisição HTTP durante a tentativa de download pelo bot | SUCCESSFUL, SOFT_404, NOT_FOUND, SERVER_ERROR, ACCESS_DENIED |
| googleCanonical | String | URL canônica eleita soberanamente pelos algoritmos de agrupamento do Google | https://exemplo.com.br/artigo (URL consolidada definitiva) |
| userCanonical | String | URL canônica formalmente declarada no HTML via rel=canonical ou cabeçalho | https://exemplo.com.br/artigo?utm_source=feed |
| crawledAs | String | Agente do Googlebot encarregado da última renderização do documento | MOBILE (Googlebot Smartphone), DESKTOP (Googlebot Desktop) |
| lastCrawlTime | Timestamp | Carimbo de data e hora UTC da última renderização completa da página | 2026-09-24T18:32:15Z (ISO 8601 UTC) |
2.4 O Confronto Crítico de Canônicas: userCanonical versus googleCanonical
Um dos maiores pontos cegos do SEO técnico convencional é a presunção equivocada de que a tag ‘rel=canonical’ inserida no código HTML é uma diretiva mandatória para os mecanismos de busca. Na realidade algorítmica do Google, o ‘userCanonical’ funciona apenas como uma sugestão orientativa de baixa autoridade comparada aos sinais comportamentais da web.
O objeto ‘googleCanonical’ revela a URL que o Google de fato elegeu para acumular PageRank, texto âncora e relevância temática. Sempre que ‘userCanonical’ e ‘googleCanonical’ divergem, ocorre uma divisão prejudicial de autoridade: o Google pode desindexar a URL inspecionada por considerá-la duplicata não declarada.
A URL Inspection API é o único instrumento disponível no mercado capaz de evidenciar essa divergência de forma automatizada em lote. Sem ela, identificar quando o Google decide canibalizar páginas de categorias, variantes de produtos ou versões paginadas torna-se uma tarefa inviável.
2.5 Limites de Cota, Concorrência e Arquitetura de Subpropriedades
A Google Search Console URL Inspection API opera sob um regime estrito de cotas para proteger a infraestrutura global contra abusos de processamento. O limite oficial estabelecido é de 2.000 requisições diárias por propriedade do Search Console e um teto de 600 requisições por minuto por projeto registrado no Google Cloud Platform.
Para portais que ultrapassam centenas de milhares de URLs, esgotar a cota de 2.000 chamadas em poucos minutos é um risco imediato se o script não for arquitetado com inteligência. Quando uma aplicação excede esse volume, a API retorna instantaneamente o erro HTTP 429 (Too Many Requests), interrompendo todo o fluxo operacional.
Para contornar essa restrição em grandes plataformas, adota-se o padrão arquitetural de subpropriedades de Prefixo de URL. Ao cadastrar propriedades segmentadas por pastas (‘/blog/’, ‘/produtos/’, ‘/downloads/’), cada prefixo adquire sua própria franquia de 2.000 requisições diárias, multiplicando a capacidade de inspeção.
3. Decodificando os Estados de Cobertura Críticos: Diagnóstico Forense de Causas-Raiz
Interpretar adequadamente o atributo ‘coverageState’ retornado pela API é o alicerce que distingue um operador comum de um verdadeiro engenheiro de SEO. Cada string devolvida pelo Googlebot encapsula uma hipótese de falha técnica, sobrecarga de infraestrutura ou rejeição algorítmica por insuficiência de qualidade.
Tratar todas as páginas desindexadas sob uma mesma estratégia genérica é um erro que consome meses de esforço sem produzir resultados orgânicos. É imperativo mapear a causa-raiz exata de cada estado e acionar o protocolo de remediação adequado na camada de software, conteúdo ou servidor.
3.1 Rastreada – Atualmente Não Indexada: Qualidade e Algoritmos de Filtragem
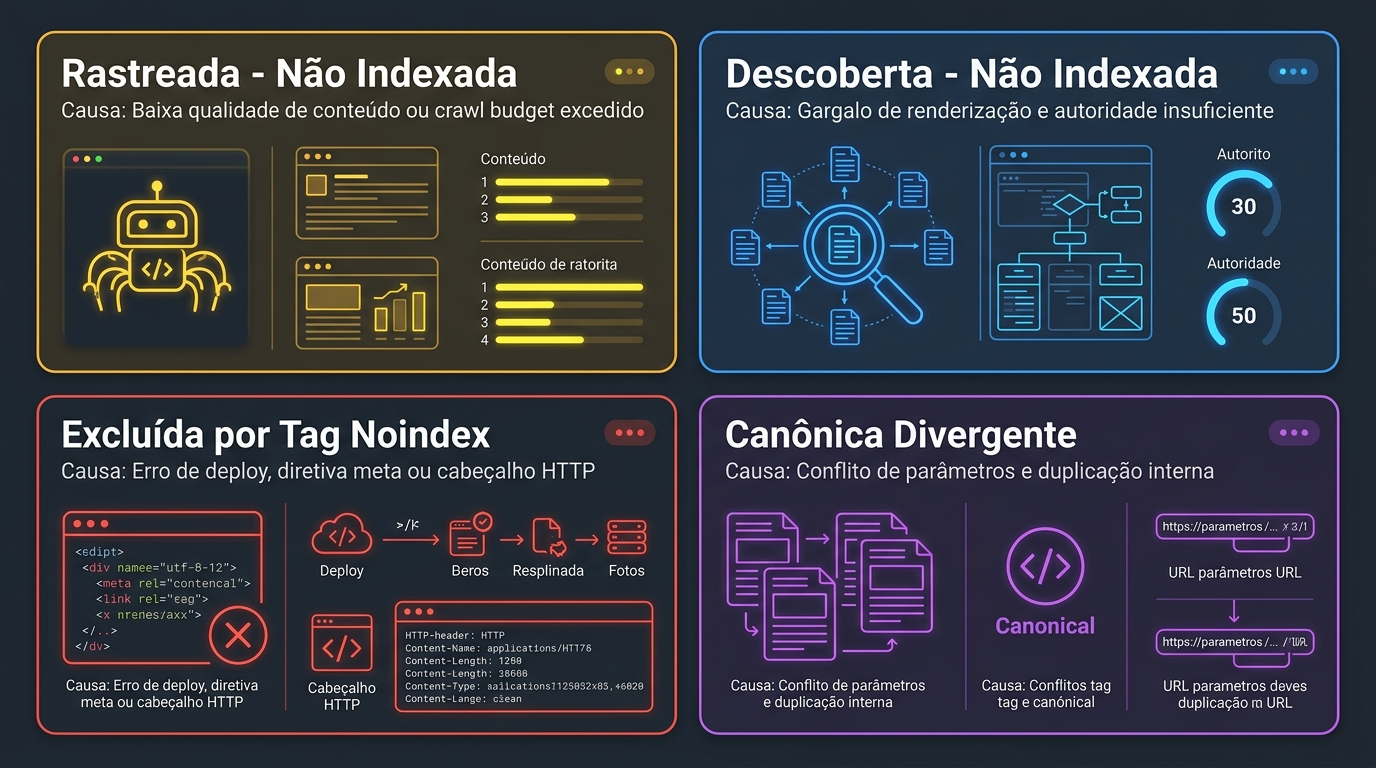
O status ‘Crawled – currently not indexed’ representa o diagnóstico mais desafiador da auditoria técnica. Ele comprova categoricamente que o Googlebot não teve nenhum obstáculo para acessar a URL: a requisição HTTP retornou código 200, a página foi baixada com sucesso e renderizada sem erros.
Contudo, após a análise semântica e a extração do Document Object Model (DOM), os algoritmos de qualidade (como Panda, Helpful Content System e Navboost) deliberadamente descartaram o documento. O sistema de indexação determinou que a página não agrega valor informacional suficiente para justificar o custo de armazenamento contínuo em seus clusters de servidores primários.
Esse estado prolifera em páginas com textos excessivamente sintéticos (‘thin content’), descrições de produtos copiadas integralmente de catálogos de fornecedores ou traduções automáticas brutas. A remediação exige enriquecimento editorial profundo, fusão de URLs duplicadas ou poda seletiva (content pruning) para preservar a integridade do domínio.
3.2 Descoberta – Atualmente Não Indexada: Gargalos de Rastreamento e Crawl Budget
Diferente do caso anterior, ‘Discovered – currently not indexed’ indica que o Googlebot tomou conhecimento da existência da URL, mas sequer tentou requisitá-la ao servidor web. A URL foi encontrada em sitemaps XML, em links internos ou através de referências externas, mas permanece estacionada na fila de espera de rastreamento (Crawl Queue).
Esse sintoma aponta para dois gargalos técnicos clássicos: exaustão do Crawl Budget ou latência intolerável na resposta da infraestrutura do site. Se o servidor apresenta Time to First Byte (TTFB) elevado ou taxa de erros transitórios (código 503), o Googlebot reduz automaticamente o ritmo de varredura para não derrubar a aplicação.
Além disso, páginas localizadas a uma profundidade excessiva de navegação (mais de 4 ou 5 cliques a partir da home) sofrem dessa estagnação devido ao PageRank interno insignificante. A solução envolve otimizar o tempo de resposta do servidor, implementar cache perimetral e reorganizar a arquitetura de links com hubs contextuais.
3.3 Excluída por Tag Noindex: Acidentes de Deploy e Falhas em CI/CD
O status ‘Excluded by noindex tag’ é frequentemente o resultado de acidentes operacionais humanos durante a publicação de versões em esteiras de integração contínua (CI/CD). Em ecossistemas ágeis, é comum que ambientes de teste ou homologação utilizem a diretiva global `<meta name=”robots” content=”noindex”>` para impedir indexação acidental.
Quando variáveis de ambiente falham durante a etapa de build de produção, a tag noindex é propagada para o domínio principal, desindexando milhares de páginas comerciais em poucas horas. Sem uma automação de SEO com Python consultando a API, esse desastre pode passar completamente despercebido por semanas enquanto o tráfego orgânico evapora.
A URL Inspection API detecta essa falha de imediato através da combinação entre ‘coverageState’ e ‘indexingState: BLOCKED_BY_META_TAG’. Alertas automatizados acoplados a esse diagnóstico permitem que engenheiros de confiabilidade realizem o rollback do deploy em questão de minutos.
3.4 Canônica Divergente: Canibalização Semântica e Conflito de Parâmetros
O estado ‘Duplicate, Google chose different canonical than user’ ocorre quando os algoritmos de desduplicação do Google rejeitam a URL indicada na tag canonical e selecionam outra página como prioritária. Esse conflito é endêmico em sites de comércio eletrônico dotados de faceted search (navegação por facetas), paginações e filtros complexos de ordenação.
Quando o Googlebot identifica que duas páginas compartilham mais de 90% de similaridade de texto visível, ele ignora a diretiva do desenvolvedor e consolida todas as métricas na URL que julga mais confiável. Se essa decisão convergir para uma URL obsoleta ou fora de estoque, a conversão do e-commerce é severamente prejudicada.
Rastrear esse desencontro programaticamente possibilita identificar falhas sistêmicas em templates de e-commerce, parâmetros ausentes no robots.txt ou incoerências em sitemaps XML. A harmonização de sinais canônicos é um dos trabalhos de maior impacto financeiro em auditorias técnicas avançadas.
4. Arquitetura de Engenharia de Dados: O Pipeline Python de Inspeção em Lote
Construir uma ferramenta de auditoria de SEO em escala industrial exige a aplicação de princípios rigorosos de engenharia de software e confiabilidade de dados. Um script amador que executa laços simples de requisições sequenciais falhará inevitavelmente ao colidir com limites de taxa, interrupções de conexão ou instabilidades na rede.
A arquitetura ideal para inspeção em lote é estruturada em torno de quatro pilares essenciais: autenticação sem intervenção humana via Contas de Serviço (Service Accounts), controle de vazão (Rate Limiting) adaptativo, persistência transacional em banco de dados SQLite para retomada de tarefas (resumability) e processamento analítico com Pandas.
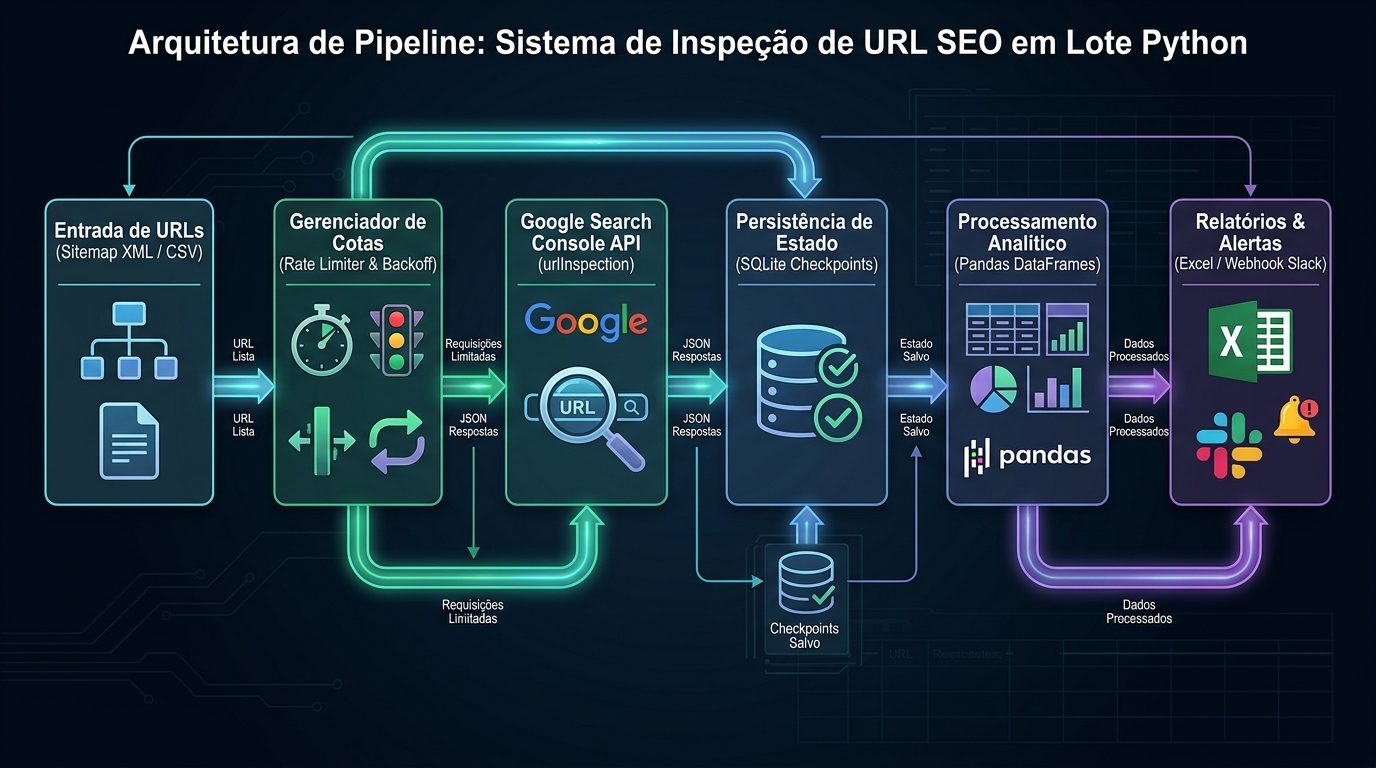
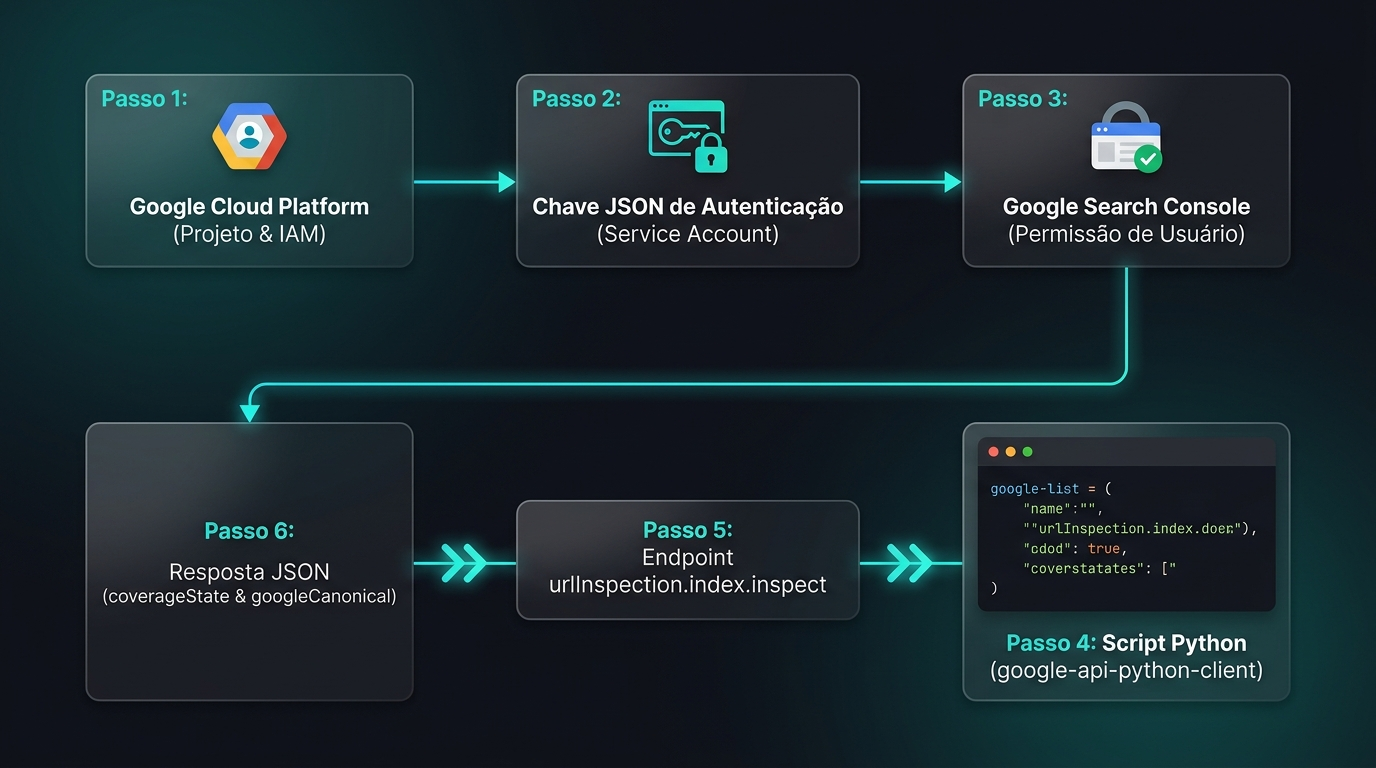
4.1 Configuração do Google Cloud Console e Credenciais de Service Account
Para viabilizar execuções autônomas que não dependam de popups de consentimento OAuth ou tokens com validade de 60 minutos, utiliza-se uma Service Account no Google Cloud Platform. Essa conta especial representa a identidade do próprio script, autenticando-se por meio de um par de chaves assimétricas criptografadas.
O processo de configuração no console do GCP exige os seguintes passos sequenciais objetivos: primeiro, crie um novo projeto dedicado ou selecione um existente; segundo, navegue até ‘APIs e Serviços’ e ative explicitamente a ‘Google Search Console API’; terceiro, acesse a aba ‘IAM e Administração’ > ‘Contas de Serviço’ e clique em ‘Criar Conta de Serviço’.
Após definir o nome da conta de serviço, avance para a aba ‘Chaves’, selecione ‘Adicionar Chave’ > ‘Criar nova chave’ e escolha o formato JSON. O download do arquivo de credenciais (`service_account.json`) conterá a chave privada utilizada pelo SDK do Google para assinar as requisições com segurança de padrão bancário.
4.2 Delegação de Permissões no Google Search Console
Possuir uma credencial ativa no Google Cloud não concede acesso automático aos dados do site; é obrigatório autorizar formalmente a conta no painel do Google Search Console. Copie o endereço de e-mail exclusivo gerado para a Service Account (com terminação `@seu-projeto.iam.gserviceaccount.com`).
No Search Console, selecione a propriedade desejada, navegue até ‘Configurações’ no menu lateral e clique em ‘Usuários e permissões’. Clique no botão ‘Adicionar usuário’, cole o e-mail da Service Account e conceda a permissão de nível ‘Restrita’ (suficiente para leitura de relatórios e inspeção) ou ‘Total’.
Em propriedades do tipo Domínio com múltiplos administradores, pode ser necessário verificar a propriedade no Google Webmaster Central para propagação instantânea. Concluída essa etapa, o script Python terá canal aberto e seguro para inspecionar qualquer URL pertencente à propriedade cadastrada.
4.3 Gerenciamento de Taxa (Rate Limiting) e Backoff Exponencial com Jitter
A manipulação de chamadas concorrentes a APIs de busca exige disciplina técnica no consumo de recursos. O limite de 600 requisições por minuto por projeto significa que o script deve respeitar um intervalo médio de segurança de pelo menos 110 a 150 milissegundos entre disparos.
Além do controle proativo de velocidade, é indispensável implementar o algoritmo de Backoff Exponencial com Jitter para capturar e tratar exceções HTTP 429 e erros transitórios 500 ou 503. Quando um bloqueio temporário é detectado, a rotina pausa a execução por um intervalo que cresce geometricamente: 2 segundos, 4 segundos, 8 segundos, somados a um ruído pseudo-aleatório.
Esse mecanismo impede o ‘efeito manada’ (thundering herd problem) e assegura que lotes de inspeção volumosos concluam sua execução de ponta a ponta sem abortar prematuramente. A resiliência contra falhas transitórias é o traço definitivo que diferencia uma automação profissional de scripts descartáveis.
4.4 Persistência de Estado e Checkpoints Resilientes com SQLite
Processar lotes de 2.000 a 10.000 URLs consome tempo e está sujeito a instabilidades de conexão local, interrupções elétricas ou cancelamento manual do processo. Armazenar resultados unicamente na memória RAM em variáveis voláteis ou estruturas transitórias acarreta perda integral do progresso em caso de pane.
A incorporação de um banco de dados relacional embutido SQLite resolve esse desafio de maneira elegante e sem exigir infraestrutura externa de servidores. Cada URL inspecionada é imediatamente gravada em uma tabela `url_inspections`, acompanhada do timestamp UTC e do payload serializado.
Ao inicializar um lote de execução, o script executa uma consulta rápida para descartar URLs inspecionadas nas últimas 24 horas, retomando exatamente do ponto de interrupção. Essa estratégia garante idempotência operacional e evita desperdício inútil da preciosa cota diária de requisições da propriedade.
5. Implementação Prática: O Script Python Completo de Auditoria em Lote
Nesta seção, consolidamos toda a teoria arquitetural em uma solução prática, testada e pronta para implantação em ambientes corporativos de produção. O código foi construído com foco em tipagem estática opcional, tratamento exaustivo de exceções e separação clara de responsabilidades entre classes.
Para executar a ferramenta em seu ambiente, certifique-se de instalar as dependências necessárias através do gerenciador de pacotes pip: ‘pip install google-api-python-client google-auth pandas openpyxl requests’.
5.1 Código-Fonte Completo e Comentado da Classe GSCBatchInspector
O bloco abaixo encapsula a classe principal `GSCBatchInspector`. Ela orquestra a autenticação OAuth 2.0, o banco SQLite de checkpoints e o loop resiliente com backoff exponencial:
# [PYTHON GSCBATCHINSPECTOR]
import os
import time
import json
import random
import sqlite3
import logging
from typing import List, Dict, Any, Optional
import requests
import xml.etree.ElementTree as ET
import pandas as pd
from google.oauth2 import service_account
from googleapiclient.discovery import build
from googleapiclient.errors import HttpError

logging.basicConfig(level=logging.INFO, format="%(asctime)s [%(levelname)s] %(message)s")

class GSCBatchInspector:
    SCOPES = ["https://www.googleapis.com/auth/webmasters.readonly"]

    def __init__(self, key_path: str, site_url: str, db_path: str = "gsc_inspection.db"):
        self.site_url = site_url
        self.db_path = db_path
        self.credentials = service_account.Credentials.from_service_account_file(
            key_path, scopes=self.SCOPES
        )
        self.service = build("searchconsole", "v1", credentials=self.credentials, cache_discovery=False)
        self._init_database()

    def _init_database(self) -> None:
        """Inicializa a tabela SQLite para garantir persistência e retomada de tarefas."""
        with sqlite3.connect(self.db_path) as conn:
            cursor = conn.cursor()
            cursor.execute("""
                CREATE TABLE IF NOT EXISTS url_inspections (
                    url TEXT PRIMARY KEY,
                    site_url TEXT,
                    verdict TEXT,
                    coverage_state TEXT,
                    indexing_state TEXT,
                    robots_txt_state TEXT,
                    page_fetch_state TEXT,
                    google_canonical TEXT,
                    user_canonical TEXT,
                    crawled_as TEXT,
                    last_crawl_time TEXT,
                    raw_json TEXT,
                    inspected_at TIMESTAMP DEFAULT CURRENT_TIMESTAMP
                )
            """)
            conn.commit()

    def is_inspected_recently(self, url: str) -> bool:
        """Verifica se a URL já foi inspecionada para economizar cota da API."""
        with sqlite3.connect(self.db_path) as conn:
            cursor = conn.cursor()
            cursor.execute("SELECT 1 FROM url_inspections WHERE url = ?", (url,))
            return cursor.fetchone() is not None

    def inspect_url(self, url: str, max_retries: int = 5) -> Optional[Dict[str, Any]]:
        """Executa a inspeção individual com tratamento de Rate Limit e Backoff Exponencial."""
        request_body = {
            "inspectionUrl": url,
            "siteUrl": self.site_url,
            "languageCode": "pt-BR"
        }

        delay = 1.0
        for attempt in range(max_retries):
            try:
                # Respeita o limite de vazão (máx ~5-8 req/s)
                time.sleep(0.15)
                response = self.service.urlInspection().index().inspect(body=request_body).execute()
                result = response.get("inspectionResult", {})
                self._save_to_database(url, result)
                return result
            except HttpError as err:
                status_code = err.resp.status
                if status_code == 429: # Quota Exceeded / Rate Limit
                    jitter = random.uniform(0.5, 1.5)
                    wait_time = delay + jitter
                    logging.warning(f"Erro 429 (Limite Excedido) para {url}. Aguardando {wait_time:.2f}s (Tentativa {attempt+1}/{max_retries})...")
                    time.sleep(wait_time)
                    delay *= 2.0
                elif status_code in (500, 503): # Falha transitória no servidor do Google
                    time.sleep(3.0)
                else:
                    logging.error(f"Erro HTTP {status_code} ao inspecionar {url}: {err}")
                    return None
            except Exception as e:
                logging.error(f"Exceção inesperada na URL {url}: {e}")
                return None
        return None

    def _save_to_database(self, url: str, result: Dict[str, Any]) -> None:
        """Normaliza e persiste os dados detalhados da inspeção no SQLite."""
        index_res = result.get("indexStatusResult", {})
        with sqlite3.connect(self.db_path) as conn:
            cursor = conn.cursor()
            cursor.execute("""
                INSERT OR REPLACE INTO url_inspections (
                    url, site_url, verdict, coverage_state, indexing_state,
                    robots_txt_state, page_fetch_state, google_canonical,
                    user_canonical, crawled_as, last_crawl_time, raw_json
                ) VALUES (?, ?, ?, ?, ?, ?, ?, ?, ?, ?, ?, ?)
            """, (
                url,
                self.site_url,
                index_res.get("verdict"),
                index_res.get("coverageState"),
                index_res.get("indexingState"),
                index_res.get("robotsTxtState"),
                index_res.get("pageFetchState"),
                index_res.get("googleCanonical"),
                index_res.get("userCanonical"),
                index_res.get("crawledAs"),
                index_res.get("lastCrawlTime"),
                json.dumps(result, ensure_ascii=False)
            ))
            conn.commit()

    def run_batch(self, urls: List[str]) -> None:
        """Processa uma lista de URLs filtrando itens já inspecionados."""
        total = len(urls)
        logging.info(f"Iniciando auditoria em lote para {total} URLs na propriedade {self.site_url}")

        for idx, url in enumerate(urls, 1):
            if self.is_inspected_recently(url):
                logging.info(f"[{idx}/{total}] Pulando URL já persistida: {url}")
                continue

            logging.info(f"[{idx}/{total}] Inspecionando: {url}")
            res = self.inspect_url(url)
            if res:
                verdict = res.get("indexStatusResult", {}).get("verdict", "N/A")
                state = res.get("indexStatusResult", {}).get("coverageState", "N/A")
                logging.info(f" -> Resultado: {verdict} | Estado: {state}")
5.2 Ingestão Automatizada a Partir de Sitemaps XML e Arquivos CSV
Para alimentar o motor de inspeção, o script oferece suporte a fontes de dados flexíveis. A ingestão via Sitemap XML permite extrair automaticamente todas as URLs ativas cadastradas no site, com suporte a índices de sitemaps compactados em gzip ou aninhados.
Alternativamente, o desenvolvedor pode carregar uma lista customizada em arquivo CSV ou extrair URLs com perda recente de tráfego a partir da Search Analytics API. O trecho a seguir demonstra as funções auxiliares de extração de sitemap e inicialização do processo:
# [PYTHON SITEMAP INGESTION]
def extract_urls_from_sitemap(sitemap_url: str) -> List[str]:
    """Extrai URLs recursivamente de um arquivo XML de Sitemap ou Sitemap Index."""
    headers = {"User-Agent": "SEO-Audit-Agent/1.0"}
    resp = requests.get(sitemap_url, headers=headers, timeout=20)
    resp.raise_for_status()

    root = ET.fromstring(resp.content)
    # Namespaces padrão de XML de Sitemaps
    ns = {"sm": "http://www.sitemaps.org/schemas/sitemap/0.9"}

    urls = []
    # Verifica se é um sitemap index (contendo outros sitemaps)
    sub_sitemaps = root.findall("sm:sitemap/sm:loc", ns)
    if sub_sitemaps:
        for loc in sub_sitemaps:
            urls.extend(extract_urls_from_sitemap(loc.text.strip()))
    else:
        for loc in root.findall("sm:url/sm:loc", ns):
            urls.append(loc.text.strip())

    return list(dict.fromkeys(urls)) # Remove duplicatas preservando ordem

if __name__ == "__main__":
    KEY_FILE = "service_account.json"
    SITE_PROPERTY = "sc-domain:devmarto.com.br"
    SITEMAP = "https://devmarto.com.br/sitemap.xml"

    urls_to_audit = extract_urls_from_sitemap(SITEMAP)
    print(f"Total de URLs extraídas do sitemap: {len(urls_to_audit)}")

    inspector = GSCBatchInspector(key_path=KEY_FILE, site_url=SITE_PROPERTY)
    # Executa lote respeitando cota máxima diária de 2.000 requisições
    inspector.run_batch(urls_to_audit[:2000])
6. Análise Forense com Pandas e Alertas Automatizados em Tempo Real
A coleta massiva de dados brutos não gera valor prático se não for acompanhada de inteligência analítica e automação de alertas. Uma vez populada a base SQLite com os registros da auditoria, a biblioteca Pandas entra em ação para transformar milhares de linhas JSON em diagnósticos executivos claros e prioritários.
Com comandos concisos em Python, conseguimos isolar exatamente quais diretórios sofreram perdas algorítmicas, identificar divergências canônicas e calcular a velocidade de obsolescência do rastreamento. Essas descobertas alimentam dashboards visuais e acionam gatilhos imediatos nos canais de comunicação da equipe de tecnologia.
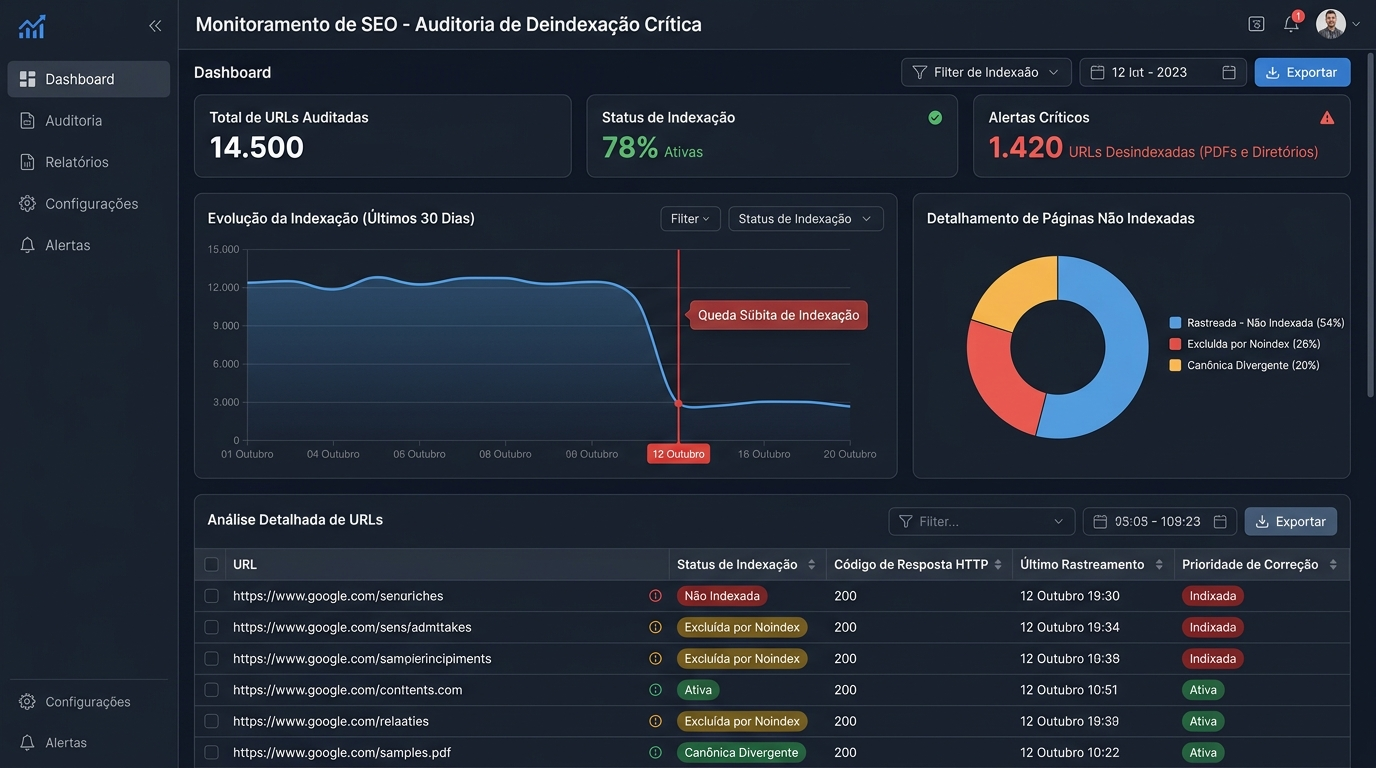
6.1 Filtragem Avançada de Anomalias e Métricas de Cobertura
A análise estatística inicial calcula a taxa de conformidade do domínio, obtida pela divisão entre URLs com veredito ‘PASS’ e o total auditado. A partir dessa linha de base, aplicamos máscaras booleanas no DataFrame para isolar os grupos de risco mais críticos que demandam intervenção imediata.
O script a seguir carrega o SQLite em um DataFrame Pandas e estrutura as quatro principais visões diagnósticas de engenharia:
# [PYTHON PANDAS ANALYSIS]
import sqlite3
import pandas as pd

def analyze_inspection_results(db_path: str = "gsc_inspection.db"):
    conn = sqlite3.connect(db_path)
    df = pd.read_sql_query("SELECT * FROM url_inspections", conn)
    conn.close()

    total = len(df)
    indexed = len(df[df["verdict"] == "PASS"])
    taxa_indexacao = (indexed / total) * 100 if total > 0 else 0

    print(f"=== RELATÓRIO EXECUTIVO DE COBERTURA ===")
    print(f"Total de URLs Auditadas: {total}")
    print(f"URLs Indexadas (PASS): {indexed} ({taxa_indexacao:.2f}%)")
    print(f"URLs Não Indexadas (FAIL/NEUTRAL): {total - indexed}\n")

    print("--- Distribuição por Estado de Cobertura (coverageState) ---")
    print(df["coverage_state"].value_counts())

    # 1. Filtro Crítico: Rastreadas mas não indexadas (Qualidade/Filtros)
    df_crawled_not_indexed = df[df["coverage_state"].str.contains("Crawled - currently not indexed", na=False)]

    # 2. Filtro Crítico: Excluídas por Noindex acidental
    df_noindex = df[df["indexing_state"].str.contains("BLOCKED_BY_META_TAG", na=False)]

    # 3. Filtro Crítico: Canônica Divergente (Google escolheu outra URL)
    df_canonical_divergent = df[
        (df["user_canonical"].notnull()) &
        (df["google_canonical"].notnull()) &
        (df["user_canonical"] != df["google_canonical"])
    ]

    return {
        "resumo": df,
        "crawled_not_indexed": df_crawled_not_indexed,
        "noindex": df_noindex,
        "canonical_divergent": df_canonical_divergent
    }
6.2 Exportação de Relatórios Executivos em Planilhas Excel Multi-Aba
Engenheiros de dados e SEOs técnicos precisam comunicar descobertas complexas de maneira acessível para gerentes de produto, desenvolvedores e stakeholders de negócios. A geração programática de planilhas Excel formatadas, com abas segmentadas por severidade e cores institucionais, acelera a priorização e distribuição de tarefas no backlog de sprints.
Utilizando o motor `openpyxl` acoplado ao Pandas, o script compila o relatório executivo completo em poucos segundos. A aba principal apresenta os KPIs consolidados, enquanto as abas subsequentes isolam a lista exata de URLs afetadas com seus respectivos parâmetros de renderização.
# [PYTHON EXCEL EXPORT]
def export_executive_report(analysis_dict: dict, output_file: str = "relatorio_auditoria_gsc.xlsx"):
    """Exporta todas as análises para uma pasta de trabalho Excel multi-aba organizada."""
    with pd.ExcelWriter(output_file, engine="openpyxl") as writer:
        analysis_dict["resumo"].to_excel(writer, sheet_name="Todas as URLs", index=False)
        analysis_dict["crawled_not_indexed"].to_excel(writer, sheet_name="Rastreadas Não Indexadas", index=False)
        analysis_dict["canonical_divergent"].to_excel(writer, sheet_name="Canônicas Divergentes", index=False)
        analysis_dict["noindex"].to_excel(writer, sheet_name="Bloqueios Noindex", index=False)
    print(f"Relatório executivo exportado com sucesso: {output_file}")
6.3 Sistema de Notificações Automáticas via Webhook para Slack e Discord
A verdadeira observabilidade de SEO depende de sistemas de alerta que notifiquem o time no momento exato em que anomalias ultrapassam limiares de segurança. Se o script detectar que mais de 5% das URLs sofreram desindexação súbita ou que tags noindex surgiram em páginas comerciais, um webhook dispara um chamado de alerta crítico.
A função abaixo formata uma mensagem no padrão de blocos ricos do Slack (Block Kit), entregando ao canal de engenharia a dimensão do problema e o link para o relatório de diagnóstico:
# [PYTHON SLACK ALERT]
def send_slack_alert(webhook_url: str, alert_data: dict) -> None:
    """Dispara um alerta formatado para o canal de engenharia no Slack."""
    total_desindexadas = len(alert_data["crawled_not_indexed"]) + len(alert_data["noindex"])

    if total_desindexadas == 0:
        logging.info("Auditoria concluída com 100% de conformidade. Nenhum alerta necessário.")
        return

    payload = {
        "blocks": [
            {
                "type": "header",
                "text": {"type": "plain_text", "text": "🚨 ALERTA CRÍTICO: Desindexação em Massa Detectada no GSC", "emoji": True}
            },
            {
                "type": "section",
                "text": {
                    "type": "mrkdwn",
                    "text": f"*Propriedade:* `{alert_data['site_url']}`\n"
                            f"*URLs Não Indexadas:* `{total_desindexadas}`\n"
                            f"• *Rastreadas mas não indexadas:* {len(alert_data['crawled_not_indexed'])}\n"
                            f"• *Bloqueadas por tag Noindex:* {len(alert_data['noindex'])}\n"
                            f"• *Conflitos de Canônica:* {len(alert_data['canonical_divergent'])}\n"
                }
            },
            {
                "type": "context",
                "elements": [{"type": "mrkdwn", "text": "Verifique o relatório anexo e acione o playbook de remediação imediatamente."}]
            }
        ]
    }

    resp = requests.post(webhook_url, json=payload, timeout=10)
    if resp.status_code == 200:
        logging.info("Notificação de alerta enviada ao Slack com sucesso.")
    else:
        logging.error(f"Falha ao enviar webhook Slack: {resp.status_code} - {resp.text}")
7. Playbook de Remediação Técnica: Protocolos Práticos de Recuperação
Identificar a desindexação de páginas é apenas a metade inicial da missão; o valor definitivo da engenharia de SEO reside na capacidade de orquestrar correções estruturais que revertam a exclusão. A recuperação do status de indexação exige um protocolo cirúrgico orientado pela causa-raiz identificada nos diagnósticos da API.
Apresentamos a seguir os planos de ação estruturados para as duas principais patologias encontradas em auditorias corporativas: a estagnação em ‘Rastreada, mas atualmente não indexada’ e os conflitos de canônica.
7.1 Protocolo de Resgate para URLs Rastreadas mas Não Indexadas
Quando centenas de páginas recaem em ‘Crawled – currently not indexed’, a causa quase invariavelmente repousa na percepção de valor único e densidade de informação atribuída pelo Googlebot. Para quebrar essa inércia algorítmica e forçar a reinclusão no índice primário, execute os seguintes passos ordenados:
Passo 1: Auditoria de Diferenciação de Conteúdo. Utilize algoritmos de similaridade textual (como Jaccard ou embeddings de linguagem) para comparar o texto visível das páginas excluídas com o restante do catálogo. Se a similaridade for superior a 75%, consolide os conteúdos em uma página definitiva ou enriqueça o documento com especificações exclusivas, dados empíricos e tabelas dinâmicas.
Passo 2: Injeção de Autoridade Interna (Internal PageRank). Páginas caem no filtro de rastreamento desindexado quando estão isoladas no rodapé da arquitetura de links. Adicione links contextuais no corpo do texto de artigos e categorias de alto tráfego (tier 1) apontando diretamente para as páginas desindexadas, utilizando âncoras variadas e semânticas.
Passo 3: Atualização de Lastmod no Sitemap XML. Modifique a tag `<lastmod>` no sitemap para a data exata da atualização e envie um novo ping de sitemap ao Google Search Console. Esse sinal informa ao rastreador que o documento sofreu alteração estrutural, incentivando uma nova visita de avaliação.
7.2 Resolução de Conflitos Canônicos e Alinhamento de Sinais
A divergência entre `userCanonical` e `googleCanonical` surge quando os sinais enviados pelo site são contraditórios ou ambíguos. Para restabelecer o domínio técnico e alinhar a canônica oficial do Google com a sua preferência de produto, adote as seguintes práticas:
Primeiro: Elimine links internos para URLs canibalizadas. Uma causa comum para o Google ignorar o `rel=canonical` é a própria arquitetura do site conter milhares de links internos apontando para a URL não-canônica. Certifique-se de que menus, breadcrumbs, banners e sitemaps XML façam referência estritamente à URL canônica limpa.
Segundo: Saneie parâmetros de URL no servidor. Para facetas de busca e filtros de produtos que geram duplicações infinitas, implemente regras de cabeçalho `Link: <url>; rel=”canonical”` em nível de backend (Nginx, Cloudflare Workers ou Apache). Configure no arquivo robots.txt o bloqueio explícito de padrões de query string inúteis que drenam Crawl Budget sem gerar novas entidades informacionais.
8. Perguntas Frequentes sobre Automação de SEO com Python (FAQ)
8.1 Quais são os limites de cota oficiais da URL Inspection API do Google Search Console?
A URL Inspection API possui um limite padrão de 2.000 requisições diárias por propriedade do Search Console e um teto de 600 requisições por minuto por projeto no Google Cloud (com pico de 10 QPS). Para propriedades com mais de 2.000 URLs, a execução deve ser escalonada ao longo de múltiplos dias ou distribuída entre subpropriedades de prefixo de URL devidamente configuradas.
8.2 Qual a diferença técnica entre ‘Rastreada – atualmente não indexada’ e ‘Descoberta – atualmente não indexada’?
‘Descoberta – atualmente não indexada’ indica que o Googlebot localizou a URL (via sitemap ou links internos), mas adiou o rastreamento para não sobrecarregar o servidor ou por considerar o sinal de autoridade da página insuficiente. Já ‘Rastreada – atualmente não indexada’ significa que o Googlebot de fato requisitou, baixou e renderizou o conteúdo da URL, mas os algoritmos de qualidade optaram deliberadamente por excluí-la do índice devido a conteúdo ralo, duplicado ou falta de valor único agregado.
8.3 Por que a URL Inspection API é superior a comandos manuais como ‘site:’ ou ao scraping de SERP?
A interface do Search Console limita a visualização agregada a amostras de até 1.000 URLs e os operadores de busca (como site: e info:) sofrem com amostragem estatística e atrasos de sincronização entre data centers. A URL Inspection API retorna a verdade algorítmica exata armazenada nos servidores do Google, incluindo a canonical selecionada pelo Googlebot (googleCanonical), a versão rastreada (mobile ou desktop), o carimbo exato da renderização (lastCrawlTime) e o veredito de indexabilidade em tempo real.
8.4 Como tratar o erro HTTP 429 (Too Many Requests) e limites de cota em scripts Python de SEO?
Para tratar o erro HTTP 429 de exaustão de cota, deve-se implementar um mecanismo de Backoff Exponencial com Jitter. O algoritmo intercepta a exceção HttpError, calcula um tempo de espera progressivo (base * 2^tentativa + variação pseudo-aleatória) e reenvia a requisição de forma controlada, garantindo resiliência total contra interrupções de conexão ou saturação momentânea da API.
8.5 Por que o Google seleciona uma canônica diferente da declarada (googleCanonical vs. userCanonical)?
O Google trata a tag rel=canonical apenas como uma sugestão orientativa de baixa autoridade comparada aos sinais empíricos da web. Se houver divergência entre a URL indicada pelo usuário e sinais externos como textos âncora internos, estrutura de sitemaps XML, redirecionamentos ou forte similaridade de conteúdo em páginas de facetas, os algoritmos consolidam as métricas de ranqueamento na URL que consideram mais representativa (googleCanonical).
8.6 É possível usar a URL Inspection API para solicitar reindexação de páginas em massa?
Não. A URL Inspection API foi projetada exclusivamente como uma ferramenta de leitura e diagnóstico do Stored Index (índice armazenado). Ela não possui endpoints para solicitar rastreamento forçado em massa. Para acelerar o rastreamento após correções, deve-se atualizar a tag lastmod no sitemap XML e reenviá-lo, ou usar a Google Indexing API (exclusiva para páginas com JobPosting ou BroadcastEvent).
8.7 Como agendar a execução do script Python de auditoria em produção de forma contínua?
A melhor prática de produção é containerizar o script Python com Docker e agendá-lo via Google Cloud Run Jobs ou cron jobs semanais em instâncias Linux/GitHub Actions. O script consulta as URLs em lotes diários de 2.000 requisições, persiste os estados no SQLite e dispara notificações automáticas via webhook para canais do Slack ou Discord quando anomalias de cobertura ultrapassam os limites tolerados.
9. Conclusão: A Era da Engenharia de Confiabilidade de SEO (SEO SRE)
O cenário de busca orgânica em 2026 não tolera mais abordagens artesanais e auditorias manuais esporádicas. À medida que os algoritmos do Google intensificam filtros de qualidade orientados por inteligência artificial e os custos de computação tornam o rastreamento mais seletivo, a governança técnica de URLs torna-se uma disciplina de engenharia contínua.
A incorporação de pipelines em Python integrados à Google Search Console URL Inspection API eleva o patamar operacional da organização. Transformamos o SEO de uma função reativa e incerta em um sistema de Engenharia de Confiabilidade de Busca (Search Reliability Engineering – SEO SRE), onde a saúde do catálogo é monitorada com métricas objetivas, limites de tolerância e respostas automáticas a falhas.
Dominar a automação de SEO com Python, controlar cotas de API e orquestrar alertas proativos não é apenas um diferencial competitivo: é o único escudo eficaz para proteger o patrimônio orgânico do seu negócio em escala industrial.