O que você vai aprender:
Análise de Logs de Servidor em 2026: Como Rastrear Googlebot, ClaudeBot e PerplexityBot em Tempo Real
1. A Renascença da Análise de Logs no SEO Técnico e o Tsunami de Crawlers de IA
A análise de logs de servidor voltou a ser o pilar central e mais estratégico da engenharia de SEO técnico em 2026. A proliferação exponencial de modelos de linguagem, motores de busca generativa e raspadores autônomos de inteligência artificial alterou drasticamente o perfil de tráfego que atinge os servidores web globais.
Hoje, robôs automatizados respondem por mais de 50% de todas as conexões HTTP registradas na maioria dos portais corporativos e e-commerces de médio e grande porte. Diferente do cenário histórico em que o Googlebot e o Bingbot monopolizavam as varreduras de indexação, administradores de sistemas enfrentam agora uma verdadeira torrente de novos agentes de varredura.
Robôs como ClaudeBot, PerplexityBot, GPTBot e ByteSpider realizam requisições em padrões agressivos e imprevisíveis. Compreender com precisão cirúrgica quem está acessando o seu ecossistema, com que frequência e consumindo quais recursos de computação tornou-se indispensável para defender a performance da aplicação e a viabilidade financeira da infraestrutura.
1.1 A Cegueira das Ferramentas Tradicionais: Por Que GA4 e Search Console Não Bastam
A imensa maioria dos profissionais de marketing digital ainda opera sob a falsa premissa de que plataformas analíticas no navegador oferecem visibilidade suficiente sobre a atividade dos robôs de busca. Ferramentas como o Google Analytics 4 (GA4) dependem estritamente da execução de tags JavaScript no cliente e utilizam filtros automáticos que descartam sumariamente o tráfego gerado por agentes automatizados.
Como consequência direta dessa arquitetura, qualquer crawler que visita o site sem renderizar bibliotecas analíticas permanece 100% invisível nas dashboards convencionais de métricas. O gestor observa gráficos de tráfego humano estáveis enquanto seus servidores de aplicação estão à beira do colapso devido a dezenas de milhares de raspagens simultâneas disparadas por robôs de IA.
Por sua vez, o Google Search Console fornece dados valiosos sobre o Googlebot, porém opera com uma latência temporal de até 72 horas e sofre com truncamentos amostrais severos. Além disso, o Search Console é completamente cego em relação a qualquer entidade que não pertença ao Google, ignorando a atuação maciça de Perplexity, OpenAI e Anthropic. A verdade absoluta só existe nos arquivos brutos de log do servidor.
1.2 O Impacto dos Crawlers de IA na Largura de Banda e no Custo de Infraestrutura
O apetite voraz dos grandes desenvolvedores de modelos de IA por dados atualizados transformou a raspagem da web em uma esteira industrial de alta pressão sobre a infraestrutura alheia. Diferente dos buscadores convencionais que ajustam seu ritmo com base na capacidade de resposta do servidor, muitos scrapers de IA ignoram deliberadamente sinais de saturação e diretivas de intervalo de requisição.
Em portais com grande volume de páginas de produtos ou repositórios documentais em PDF, um único crawler desregulado pode consumir terabytes de transferência de dados em poucas horas. Esse comportamento gera faturas astronômicas de serviços de nuvem e CDN (como AWS CloudFront ou Cloudflare), além de degradar severamente o Time to First Byte (TTFB) para usuários humanos reais.
A análise sistemática de logs permite quantificar exatamente quanto da sua banda mensal está sendo sequestrada por agentes de treinamento que não devolvem nenhum clique orgânico à sua marca. Com esses dados empíricos em mãos, equipes de engenharia adquirem embasamento técnico para adotar políticas seletivas de contenção e bloqueio de tráfego parasita.
1.3 A Distinção Vital: Bots de Treinamento versus Bots de Recuperação em Tempo Real (RAG)
Um erro conceitual grave cometido por equipes de tecnologia ao auditar logs é tratar todos os robôs de inteligência artificial de forma homogênea. É imperativo distinguir claramente os ‘Training Crawlers’ (robôs de treinamento em lote) dos ‘Live Retrieval Bots’ (motores de busca em tempo real baseados em Retrieval-Augmented Generation – RAG).
Os robôs de treinamento, como o GPTBot ou o Google-Extended, realizam varreduras amplas e indiscriminadas com o único objetivo de alimentar bancos de dados para a criação de futuras versões de modelos de linguagem. Bloquear esses agentes em nada prejudica a sua visibilidade orgânica imediata, servindo primariamente para proteger a propriedade intelectual e poupar recursos computacionais.
Em contrapartida, robôs de recuperação ao vivo como o OAI-SearchBot (da busca do ChatGPT) e o PerplexityBot visitam o seu site no momento exato em que um usuário final faz uma pergunta conversacional. Bloquear esses agentes significa ser sumariamente excluído das citações e links diretos recomendados pelos novos motores de busca de inteligência artificial, aniquilando a presença de marca no ecossistema de GEO.
📌 Princípio Fundamental da Governança de Bots de IA
Nunca configure um bloqueio cego e generalizado para todos os bots de IA em seu arquivo robots.txt ou firewall. Separe rigorosamente os agentes de raspagem de treinamento em lote (como CCBot e GPTBot) dos motores de busca conversacional em tempo real (como PerplexityBot e OAI-SearchBot), que geram tráfego qualificado de referência e citações de marca.
2. Anatomia dos Logs de Acesso: Configurando Nginx e Apache para Auditoria de SEO
Os arquivos de log de acesso do servidor web representam o diário de bordo mais rigoroso e inviolável da sua infraestrutura digital. Cada vez que um socket de rede estabelece uma conexão TCP e dispara um cabeçalho HTTP solicitando um recurso, o servidor web grava uma nova linha com parâmetros criptograficamente precisos.
No entanto, as configurações padrão fornecidas pelas distribuições Linux populares (como o formato ‘combined’ padrão do Nginx ou Apache) são insuficientes para diagnósticos avançados de SEO. Para transformar registros brutos em inteligência analítica acionável, é indispensável enriquecer a estrutura de gravação com variáveis de tempo de resposta e performance de upstream.
2.1 O Formato Combined e a Inclusão de Métricas de Latência ($request_time e TTFB)
O formato padrão ‘combined’ tradicional registra apenas o endereço IP do cliente, a data e hora local, o método HTTP, a URI solicitada, o código de status retornado, os bytes transmitidos, a URL de referência (Referer) e o cabeçalho User-Agent. Embora essa estrutura permita identificar qual bot visitou qual página, ela oculta a métrica mais decisiva para a alocação de Crawl Budget: a velocidade de resposta do servidor.
A métrica de tempo de resposta ($request_time no Nginx) mede o tempo total decorrido desde o recebimento do primeiro byte do cliente até a transmissão do último byte de resposta. Já a variável $upstream_response_time quantifica exatamente quantos milissegundos a aplicação de backend (como PHP-FPM, Node.js ou contêineres Docker) levou para processar a lógica e gerar o HTML.
Cruzar o User-Agent do Googlebot com o $request_time permite mapear instantaneamente gargalos de performance que induzem o mecanismo de busca a desacelerar a frequência de rastreamento do domínio. Se uma rota dinâmica consome 2.500 milissegundos para responder ao Googlebot, o orçamento de rastreamento daquela seção do site será severamente penalizado pelos algoritmos de crawl capacity.
2.2 Configuração Prática no Nginx (nginx.conf) para Extração de Logs de Alta Precisão
Para capacitar o seu servidor Nginx a capturar dados completos de auditoria de SEO, devemos declarar uma diretiva customizada `log_format` no contexto `http` do arquivo principal `nginx.conf`. Essa diretiva deve utilizar timestamps no padrão internacional ISO 8601 e isolar métricas de latência com precisão de milissegundos.
O bloco a seguir ilustra a declaração de formato recomendada para ambientes corporativos de alto tráfego com foco em observabilidade técnica:
# [NGINX CONFIGURATION]
http {
    # Declaração do formato de log avançado para auditoria de SEO e bots de IA
    log_format seo_advanced '$remote_addr - $remote_user [$time_iso8601] '
                            '"$request" $status $body_bytes_sent '
                            '"$http_referer" "$http_user_agent" '
                            'rt=$request_time urt=$upstream_response_time '
                            'scheme=$scheme host=$host ssl=$ssl_protocol';

    # Aplicação do formato ao arquivo de log de acesso
    access_log /var/log/nginx/access.log seo_advanced buffer=64k flush=5s;
}
2.3 Gerenciamento de Logs Massivos: Rotação com Logrotate e Compressão Gzip
Servidores web de portais consolidados geram gigabytes de registros textuais diariamente, o que pode esgotar o armazenamento em disco se não houver um ciclo automatizado de expurgo e rotação. O utilitário nativo do Linux `logrotate` deve ser configurado para particionar os arquivos diariamente e comprimi-los com algoritmo gzip.
A compressão em gzip reduz o volume dos arquivos de log em até 90%, preservando o histórico operacional de meses em uma fração minúscula de espaço de armazenamento. O script Python de análise deve ser desenvolvido com suporte nativo à leitura de arquivos `.gz` em streaming, permitindo auditar dados históricos sem a necessidade de descompactar arquivos massivos no sistema de arquivos.
3. Mapeamento e Classificação de Bots em 2026: Quem Está Visitando Seu Site?
Identificar a assinatura declarada de cada rastreador é o primeiro passo para organizar o inventário de conexões nos arquivos de log. Em 2026, o ecossistema de robôs de busca é amplamente fragmentado entre gigantes de indexação orgânica, laboratórios de inteligência artificial de elite e raspadores não declarados.
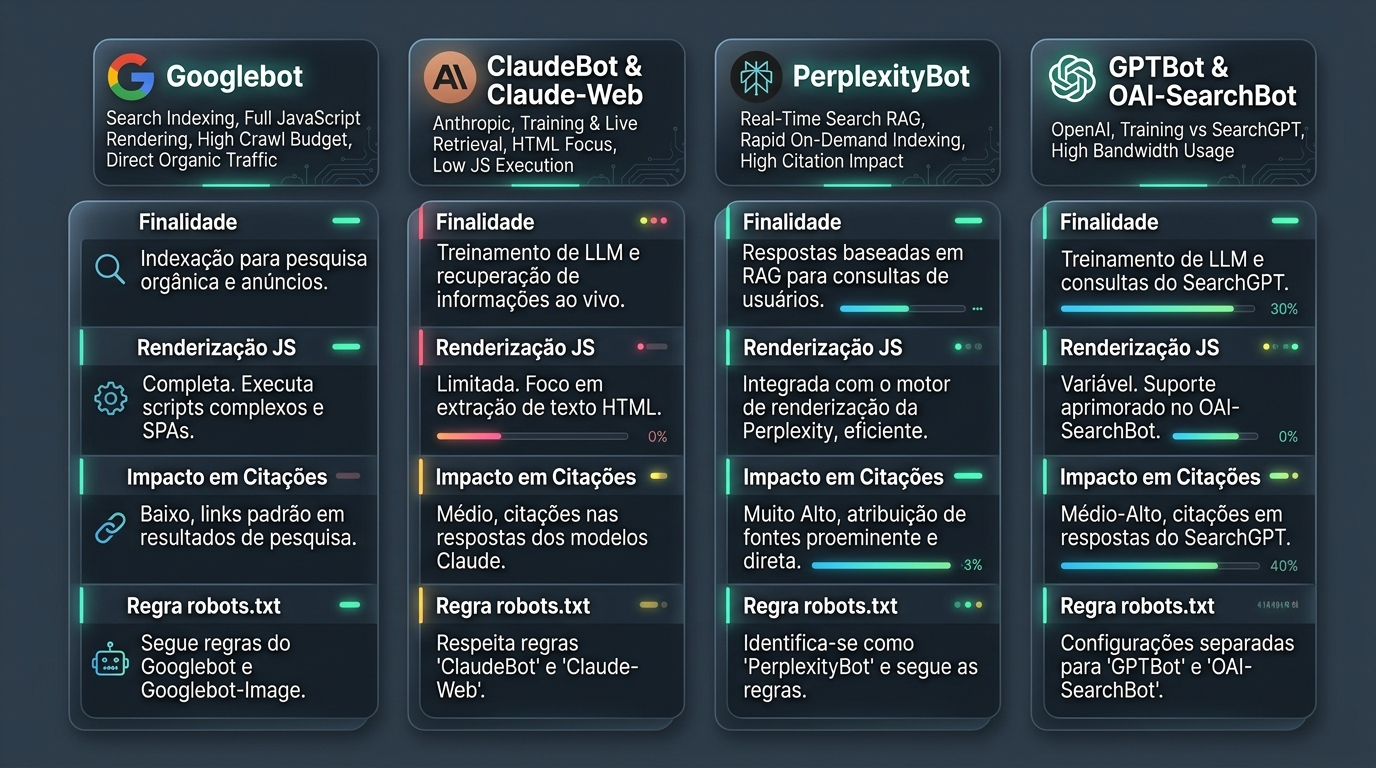
A tabela a seguir consolida os principais agentes de rastreamento operantes na web contemporânea, detalhando sua organização controladora, finalidade primária e impacto estratégico nos resultados do negócio:
| Crawler / User-Agent | Organização | Finalidade Primária | Suporte JS | Impacto em Tráfego |
|---|---|---|---|---|
| Googlebot (Smartphone/Desktop) | Indexação orgânica principal para busca e AI Overviews | Completo (WRS Headless Chrome) | Crítico (Responsável pela maior fatia de tráfego) | |
| Google-Extended | Treinamento de modelos Gemini e APIs do Vertex AI | Limitado | Nulo (Não gera cliques orgânicos diretos) | |
| ClaudeBot | Anthropic | Coleta ampla de dados para treinamento de modelos Claude | Muito Baixo (Prioriza HTML estático) | Nulo a Baixo (Foco em dados de treino) |
| Claude-Web | Anthropic | Recuperação de dados em tempo real sob demanda de usuários | Moderado | Médio (Gera citações em chats conversacionais) |
| PerplexityBot | Perplexity AI | Indexação e atualização de índice para motor de busca RAG | Otimizado (Renderização leve) | Muito Alto (Citações proeminentes e cliques diretos) |
| GPTBot | OpenAI | Coleta massiva de corpus textual para treinamento de IA | Muito Baixo | Nulo (Treinamento de modelos de base) |
| OAI-SearchBot | OpenAI | Indexação oficial para alimentar o motor SearchGPT | Moderado | Alto (Links e citações diretas no ChatGPT Search) |
| Bytespider | ByteDance | Raspagem de dados para modelos de IA da dona do TikTok | Mínimo | Nulo (Consumo abusivo de recursos do servidor) |
3.1 Googlebot e Google-Extended: Separando Busca Orgânica de Treinamento Gemini
O Google estabeleceu uma separação técnica fundamental entre o seu crawler histórico de busca orgânica e seu agente dedicado à alimentação de modelos generativos. O ‘Googlebot’ tradicional continua sendo a entidade encarregada de rastrear, renderizar e indexar conteúdos para exibição nos resultados de pesquisa e nas caixas de AI Overviews.
Por sua vez, o token ‘Google-Extended’ foi criado como um mecanismo autônomo que permite a webmasters desautorizar a utilização do seu conteúdo para o treinamento de modelos como Gemini e Imagen. Nos logs do servidor, você notará que o Google-Extended compartilha faixas de IP idênticas às do Googlebot, porém declara o token de controle no momento do handshake HTTP.
Monitorar a proporção de acessos entre essas duas assinaturas nos logs permite validar se as diretivas restritivas do seu arquivo `robots.txt` estão sendo respeitadas. Essa vigilância garante que a sua propriedade intelectual não esteja sendo minerada contra a sua vontade declarada.
3.2 ClaudeBot e Claude-Web: O Comportamento de Rastreamento da Anthropic
A Anthropic opera dois agentes distintos que apresentam frequências de varredura bastante contrastantes nos arquivos de log corporativos. O ‘ClaudeBot’ opera em modo de lote contínuo, percorrendo links públicos de sitemaps para extrair artigos e documentações sem interação humana simultânea.
Já o ‘Claude-Web’ é disparado exclusivamente quando um usuário interage com o assistente Claude e compartilha uma URL para análise ou faz uma pergunta factual que requer acesso à web ao vivo. Nos logs, os acessos do Claude-Web surgem como requisições isoladas e pontuais com código HTTP 200, frequentemente acompanhadas de parâmetros específicos de requisição.
Estudos técnicos de comportamento de rastreadores indicam que ambos os agentes da Anthropic priorizam pesadamente documentos estáticos com HTML limpo e semântico. Páginas que dependem de hidratação tardia em JavaScript para exibir texto visível são frequentemente interpretadas como páginas vazias por esses robôs.
3.3 PerplexityBot e Perplexity-User: A Esteira de Citações RAG em Tempo Real
O Perplexity consolidou-se como o motor de busca conversacional mais agressivo e eficiente na indexação de conteúdos técnicos em tempo real. O agente ‘PerplexityBot’ visita domínios com alta frequência para alimentar seu índice primário de conhecimento, priorizando websites com excelente tempo de carregamento e autoridade temática.
Quando um usuário realiza uma pesquisa em sua interface conversacional, o sub-agente ‘Perplexity-User’ executa buscas direcionadas em fração de segundos. Rastrear essas entradas nos logs fornece correlação direta e imediata com os picos de tráfego de referência e menções de marca detectados na ferramenta analítica.
Garantir que as rotas mais importantes do seu site respondam com latência inferior a 300 milissegundos para o PerplexityBot é o fator determinante para conquistar o primeiro parágrafo de citação nas respostas do motor. A análise de logs é o único canal capaz de auditar se as suas páginas estão sendo alcançadas com sucesso ou bloqueadas por firewalls corporativos.
3.4 GPTBot e OAI-SearchBot: A Fronteira entre Raspagem de Dados e Indexação SearchGPT
A OpenAI refinou sua taxonomia de agentes automatizados ao lançar oficialmente sua iniciativa de mecanismos de busca. Historicamente, o ‘GPTBot’ era o único identificador visível nos servidores, sendo amplamente bloqueado por empresas preocupadas com o treinamento não remunerado de modelos de linguagem.
Com a introdução do ‘OAI-SearchBot’, a empresa estabeleceu uma entidade de indexação transparente exclusiva para alimentar os resultados do ChatGPT Search. Bloquear o GPTBot impede o uso dos seus dados em modelos futuros de fundação, enquanto permitir o OAI-SearchBot garante que o seu domínio continue sendo sugerido como fonte oficial aos milhões de usuários da plataforma.
A auditoria de logs permite constatar se o OAI-SearchBot já está varrendo os seus sitemaps XML e com que velocidade novos artigos publicados são absorvidos pelo índice da OpenAI. Essa observabilidade é crucial para validar estratégias modernas de Generative Engine Optimization (GEO).
3.5 Scrapers Hostis e Bots Agressivos: Bytespider, CCBot e Crawlers Não Declarados
Nem todos os robôs presentes na internet operam com integridade e respeito aos padrões éticos de consumo de recursos. Agentes como o ‘Bytespider’ (associado à ByteDance) e o ‘CCBot’ (Common Crawl) são notórios na comunidade técnica por disparar centenas de requisições por segundo em um único domínio, simulando ataques de negação de serviço (DoS).
Esses raspadores muitas vezes ignoram parâmetros de limite de taxa no robots.txt e insistem em percorrer rotas dinâmicas pesadas, como carrinhos de compras e filtros de busca interna. Sem uma estratégia de identificação ágil nos logs, esses bots hostis consomem a capacidade de concorrência do servidor, impedindo que o Googlebot acesse o catálogo legítimo da loja.
4. Engenharia de Detecção: Verificação Dupla por Reverse DNS (rDNS) contra Spoofing
A regra mais elementar da segurança da informação e da engenharia de redes afirma categoricamente: nunca confie no cabeçalho HTTP User-Agent. Por ser um cabeçalho arbitrário transmitido pelo cliente na camada de aplicação, qualquer script amador de Python ou comando cURL pode assinar sua requisição com a frase exata do Googlebot.
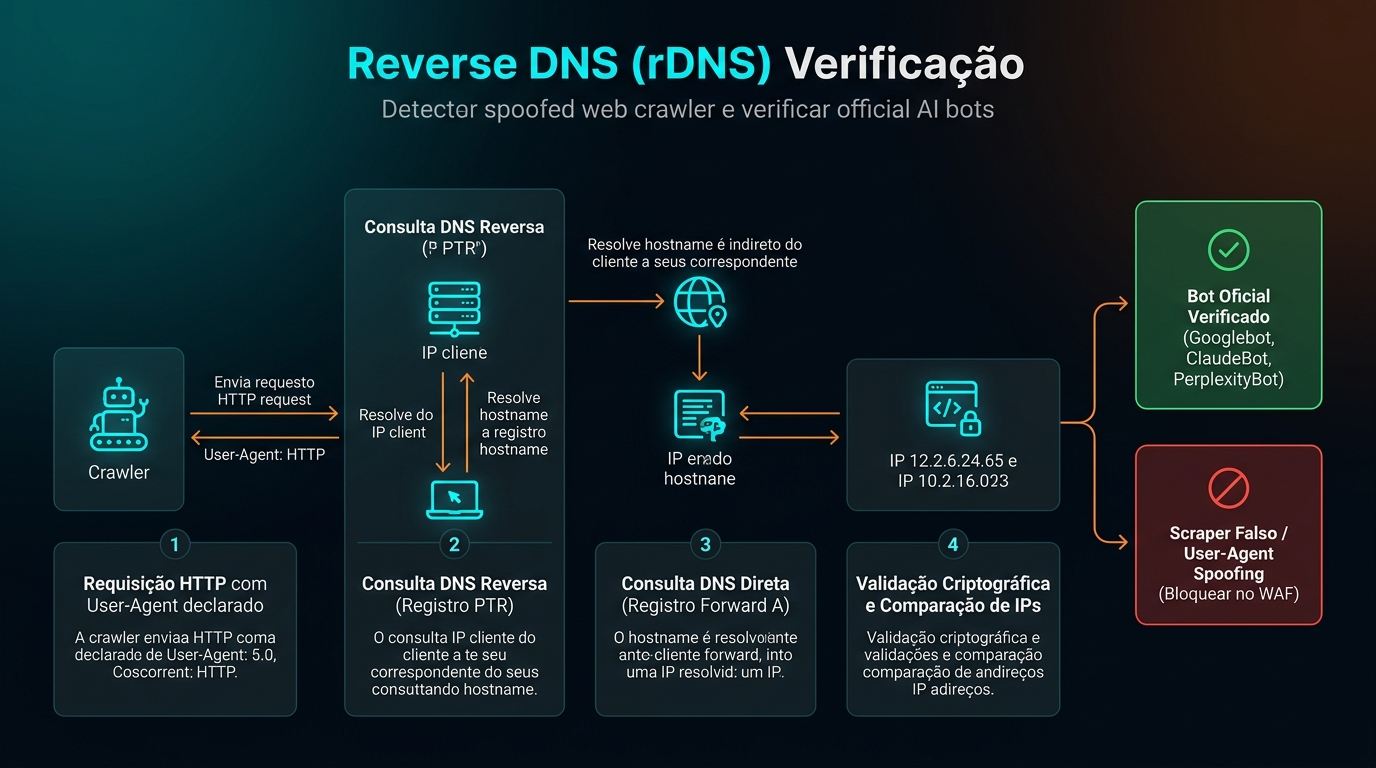
Atacantes mal-intencionados, concorrentes predatórios e scrapers piratas utilizam User-Agent Spoofing sistematicamente para contornar regras ingênuas de firewall que liberam tráfego para buscadores. A única metodologia infalível e recomendada oficialmente pelo Google, Anthropic e OpenAI para atestar a legitimidade de um bot é a verificação dupla por Reverse DNS (rDNS).
4.1 A Ilusão do User-Agent: Por Que Qualquer Scraper Pode Falsificar Sua Identidade
Em auditorias forenses de logs corporativos, é comum constatar que entre 15% e 40% de todas as requisições que se declaram como ‘Googlebot’ nos cabeçalhos são, na verdade, scrapers falsificados. Hackers sabem que a maioria das equipes de infraestrutura libera ips que declaram ser robôs de busca para não prejudicar o ranqueamento orgânico.
Ao explorar essa brecha, scrapers hostis extraem dados proprietários, testam vulnerabilidades de software e sobrecarregam servidores sob o disfarce de um rastreador respeitável. Se o seu pipeline de análise de logs computa essas linhas como visitas oficiais do Google, todo o seu diagnóstico de Crawl Budget e frequência de rastreamento estará irremediavelmente corrompido.
4.2 O Algoritmo de Verificação Dupla: Consulta PTR e Checagem Forward A
O protocolo de verificação reversa de DNS é composto por duas etapas matemáticas rigorosas e interdependentes. No primeiro passo, o script captura o endereço IP de origem registrado no log e executa uma consulta DNS reversa (registro PTR), obtendo o hostname canônico associado àquele endereço.
Em seguida, valida-se se o domínio do hostname retornado pertence oficialmente à organização reivindicada (por exemplo, terminando estritamente em `.googlebot.com`, `.google.com` ou `.anthropic.com`). No segundo passo, o script executa uma consulta DNS direta (Forward A record) sobre o hostname obtido, resolvendo-o novamente para um endereço IP numérico.
Se e somente se o IP resolvido na etapa direta for rigorosamente idêntico ao IP que disparou a requisição no arquivo de log, o rastreador é classificado como ‘Bot Oficial Verificado’. Se os endereços divergirem ou o hostname não pertencer aos domínios autorizados, a requisição é confirmada como fraude (spoofing) e deve ser descartada da base de SEO e bloqueada no firewall.
4.3 Otimização de Performance com Cache LRU em Memória para Consultas DNS
Executar consultas de rede DNS para cada uma de centenas de milhares de linhas de log tornaria o processamento do pipeline em Python impraticavelmente lento. Como a grande maioria das requisições legítimas de um mesmo bot provém de um conjunto repetido de algumas centenas de endereços IP de data center, o uso de cache local é mandatório.
A utilização do decorador `@functools.lru_cache` na função de validação DNS reduz o tempo total de processamento de horas para meros minutos. Uma vez verificado um IP específico da OpenAI ou do Google, o veredito fica armazenado na memória RAM do script, permitindo consultas instantâneas para as ocorrências subsequentes.
5. O Impacto Oculto dos Bots no Crawl Budget e Diagnóstico de Desperdício
O conceito clássico de Crawl Budget (Orçamento de Rastreamento) define a quantidade de atenção e recursos de computação que o Googlebot dedica ao seu domínio em uma janela temporal. Em 2026, com os robôs de busca refinando sua eficiência e aplicando limites severos de capacidade, desperdiçar visitas em páginas inúteis é a receita mais rápida para a desindexação silenciosa.
A análise de logs é a única ferramenta diagnóstica capaz de revelar a discrepância entre a arquitetura pretendida pelo time de SEO e a jornada real percorrida pelos bots nos servidores. Frequentemente descobre-se que até 70% da atividade do Googlebot é consumida por armadilhas técnicas de rastreamento que não agregam nenhum valor comercial.
5.1 Rotas Dinâmicas, Faceted Navigation e Armadilhas de Parâmetros Infinitos
Sistemas de navegação por facetas em lojas virtuais (filtros de cor, tamanho, faixa de preço e ordenação) são os maiores vilões do desperdício de rastreamento na web. Quando filtros combinatórios geram URLs com dezenas de parâmetros de query string sem uma regra de canonicalização ou bloqueio adequada, cria-se um ‘buraco negro’ de rastreamento.
O Googlebot pode passar semanas rastreando variações irrelevantes de produtos esgotados enquanto novas categorias e lançamentos estratégicos permanecem intocados na fila de descoberta. Nos logs, esse padrão manifesta-se através de milhares de requisições com strings longas (ex: `?sort=price_asc&color=blue&size=m&page=4`), demandando intervenção imediata no arquivo robots.txt.
5.2 Análise de Códigos de Status HTTP: Correlacionando Erros 4xx e 5xx com Rastreamento
Outro sintoma crítico revelado pelos logs é a incidência de códigos de status HTTP indesejados durante as varreduras dos robôs. A presença massiva de respostas de redirecionamento (código 301 ou 302 em cadeia) obriga o bot a despender múltiplas requisições para alcançar um único conteúdo final.
Pior ainda é a proliferação de erros 404 (páginas não encontradas) e 500/503 (erros internos de servidor). Quando o Googlebot detecta um aumento repentino de respostas 5xx, seus algoritmos de proteção de host reduzem imediatamente o ritmo de rastreamento, diminuindo o Crawl Budget do site por semanas.
5.3 O Impacto do TTFB Elevado na Frequência de Visitas do Googlebot
O Googlebot é projetado com limites de tolerância de latência rigorosos para evitar derrubar aplicações durante seus ciclos de varredura. Se o Time to First Byte (TTFB) médio do seu servidor web ultrapassa 1.000 milissegundos nas rotas mais requisitadas, o rastreador ajusta a taxa de rastreamento para baixo.
Ao cruzar a variável `$request_time` dos logs com cada grupo de diretórios do site, a equipe de engenharia identifica com precisão cirúrgica quais templates necessitam de otimização de consultas ao banco de dados ou implementação de cache de página inteira via Redis ou Varnish.
6. Implementação Prática: Pipeline Python de Leitura em Streaming e Análise com DuckDB
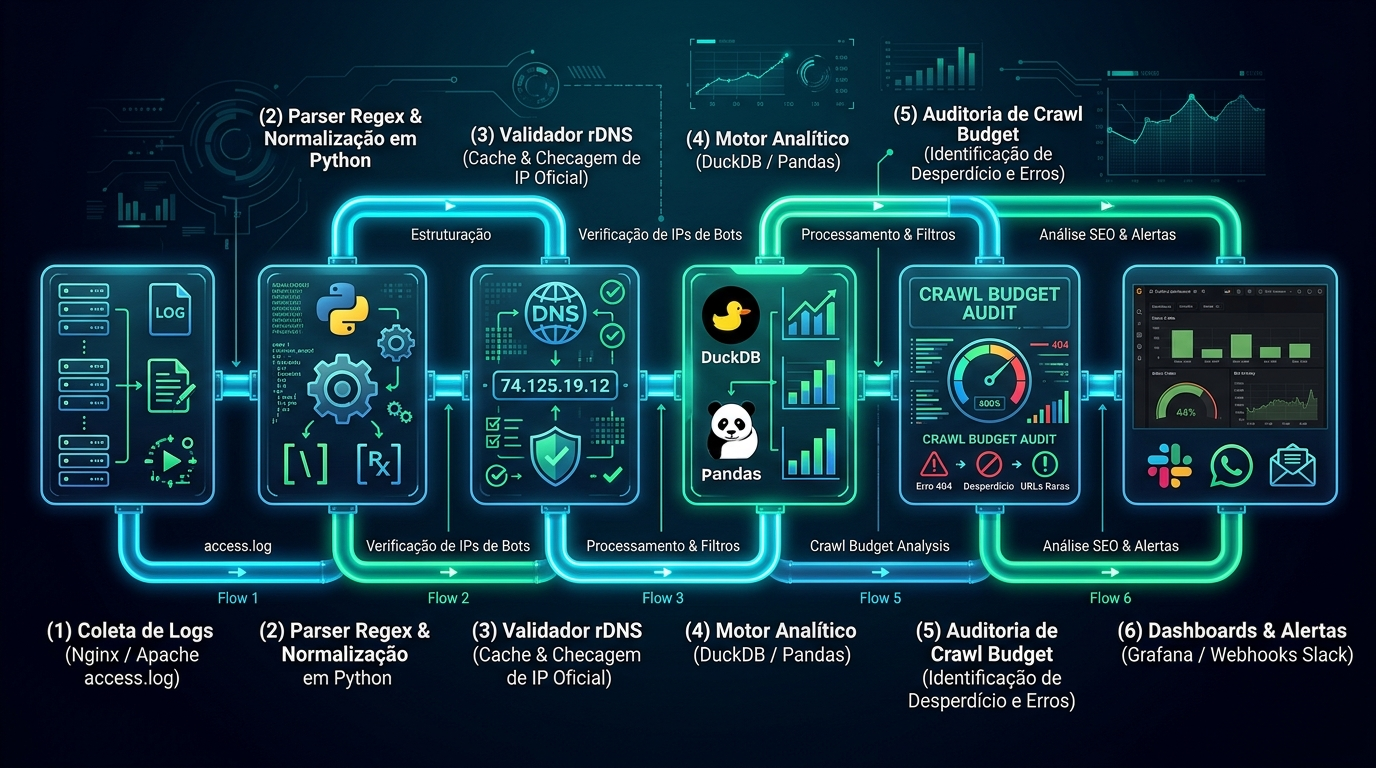
Para operacionalizar a análise de logs sem depender de softwares proprietários caros e lentos, construímos um pipeline de engenharia de dados em Python. Nossa solução utiliza expressões regulares compiladas para alta performance, leitura de arquivos em fluxo (streaming via geradores) e integração com a engine colunar DuckDB.
Essa arquitetura é capaz de processar milhões de linhas de log em arquivos compactados `.gz` consumindo menos de 300 megabytes de memória RAM, sendo viável para execução em qualquer máquina local ou esteira de CI/CD.
6.1 Arquitetura do Script: Parsing em Streaming com Expressões Regulares
O script foi concebido sob o padrão de geradores (`yield`), garantindo que o arquivo de log nunca seja carregado integralmente na memória volátil. A cada linha lida, uma expressão regular extrai os campos atômicos: endereço IP, data/hora ISO, método HTTP, URI de rota, status HTTP, bytes enviados, referenciador, User-Agent e tempo de resposta.
6.2 Código Completo do Parser e Validador rDNS em Python
O bloco abaixo traz o código funcional completo pronto para produção, incorporando resolução reversa de DNS com cache e categorização automática de robôs de IA:
# [PYTHON LOG STREAMER & RDNS]
import re
import gzip
import socket
import logging
from functools import lru_cache
from typing import Generator, Dict, Any, Optional
import duckdb
import pandas as pd

logging.basicConfig(level=logging.INFO, format="%(asctime)s [%(levelname)s] %(message)s")

# Expressão regular compilada para o formato Nginx avançado declarado anteriormente
LOG_PATTERN = re.compile(
    r'^(?P<ip>\S+) - (?P<user>\S+) \[(?P<time>[^\]]+)\] '
    r'"(?P<method>\S+) (?P<uri>\S+) (?P<protocol>[^"]+)" '
    r'(?P<status>\d{3}) (?P<bytes>\d+) '
    r'"(?P<referer>[^"]*)" "(?P<user_agent>[^"]*)" '
    r'rt=(?P<request_time>[\d\.]+) urt=(?P<upstream_time>[\d\.\-]+)'
)

# Mapeamento oficial de domínios rDNS autorizados para grandes crawlers
BOT_DOMAINS = {
    "google": [".googlebot.com", ".google.com"],
    "anthropic": [".anthropic.com", ".claude.ai"],
    "openai": [".openai.com"],
    "perplexity": [".perplexity.ai"]
}

@lru_cache(maxsize=10000)
def verify_reverse_dns(ip: str, bot_family: str) -> bool:
    """Executa a verificação dupla por Reverse DNS (rDNS) com cache LRU em memória."""
    try:
        # Passo 1: Consulta Reversa (PTR)
        hostname, _, _ = socket.gethostbyaddr(ip)
        valid_domains = BOT_DOMAINS.get(bot_family, [])
        if not any(hostname.lower().endswith(dom) for dom in valid_domains):
            return False

        # Passo 2: Consulta Direta (Forward A)
        resolved_ip = socket.gethostbyname(hostname)
        return resolved_ip == ip
    except (socket.herror, socket.gaierror):
        return False

def classify_user_agent(ua: str, ip: str) -> str:
    """Classifica o bot e atesta sua autenticidade via rDNS."""
    ua_lower = ua.lower()
    if "googlebot" in ua_lower:
        return "Googlebot (Verificado)" if verify_reverse_dns(ip, "google") else "Googlebot (Falsificado)"
    if "claudebot" in ua_lower or "claude-web" in ua_lower:
        return "ClaudeBot (Verificado)" if verify_reverse_dns(ip, "anthropic") else "ClaudeBot (Falsificado)"
    if "perplexitybot" in ua_lower:
        return "PerplexityBot (Verificado)" if verify_reverse_dns(ip, "perplexity") else "PerplexityBot (Falsificado)"
    if "gptbot" in ua_lower or "oai-searchbot" in ua_lower:
        return "OpenAI Bot (Verificado)" if verify_reverse_dns(ip, "openai") else "OpenAI Bot (Falsificado)"
    if "bytespider" in ua_lower:
        return "ByteSpider (Hostil)"
    return "Outro / Humano"

def stream_log_file(filepath: str) -> Generator[Dict[str, Any], None, None]:
    """Lê arquivos de log normais ou compactados (.gz) em modo streaming."""
    open_func = gzip.open if filepath.endswith(".gz") else open
    with open_func(filepath, "rt", encoding="utf-8", errors="replace") as f:
        for line in f:
            match = LOG_PATTERN.match(line.strip())
            if match:
                data = match.groupdict()
                bot_type = classify_user_agent(data["user_agent"], data["ip"])
                # Filtra apenas requisições de robôs identificados
                if "Outro" not in bot_type:
                    yield {
                        "ip": data["ip"],
                        "time": data["time"],
                        "method": data["method"],
                        "uri": data["uri"],
                        "status": int(data["status"]),
                        "bytes": int(data["bytes"]),
                        "request_time": float(data["request_time"]),
                        "bot_type": bot_type
                    }
6.3 Consultas SQL Analíticas de Alta Velocidade com DuckDB e Pandas
Uma vez coletadas as requisições normalizadas, o DuckDB entra em ação como motor de processamento em memória ultraveloz. O código a seguir carrega o gerador para uma tabela temporária e executa consultas analíticas forenses para extrair métricas de volume, códigos de status e latência média:
# [PYTHON DUCKDB ANALYTICS]
def run_forensic_analysis(log_path: str):
    """Executa consultas analíticas agregadas via DuckDB sobre o fluxo de logs."""
    con = duckdb.connect()

    # Cria tabela a partir do gerador streaming
    records = list(stream_log_file(log_path))
    if not records:
        print("Nenhuma requisição de bot identificada nos logs.")
        return

    df_raw = pd.DataFrame(records)
    con.register("bot_logs", df_raw)

    print("=== RELATÓRIO FORENSE DE LOGS: ATIVIDADE DE BOTS ===")

    # 1. Total de requisições por tipo de bot e verificação
    df_summary = con.execute("""
        SELECT bot_type, COUNT(*) AS total_hits,
               ROUND(AVG(request_time), 3) AS ttfb_medio,
               SUM(CASE WHEN status >= 400 THEN 1 ELSE 0 END) AS erros_http
        FROM bot_logs
        GROUP BY bot_type
        ORDER BY total_hits DESC
    """).df()
    print(df_summary)

    # 2. Rotas que mais consomem Crawl Budget do Googlebot
    print("\n--- Top 10 Rotas Mais Rastreadas pelo Googlebot ---")
    df_google_routes = con.execute("""
        SELECT uri, COUNT(*) AS hits, ROUND(AVG(request_time), 3) AS ttfb_medio
        FROM bot_logs
        WHERE bot_type = 'Googlebot (Verificado)'
        GROUP BY uri
        ORDER BY hits DESC
        LIMIT 10
    """).df()
    print(df_google_routes)

    return df_summary, df_google_routes
7. Automação de Alertas em Tempo Real e WAF: Bloqueio Cirúrgico de Scrapers
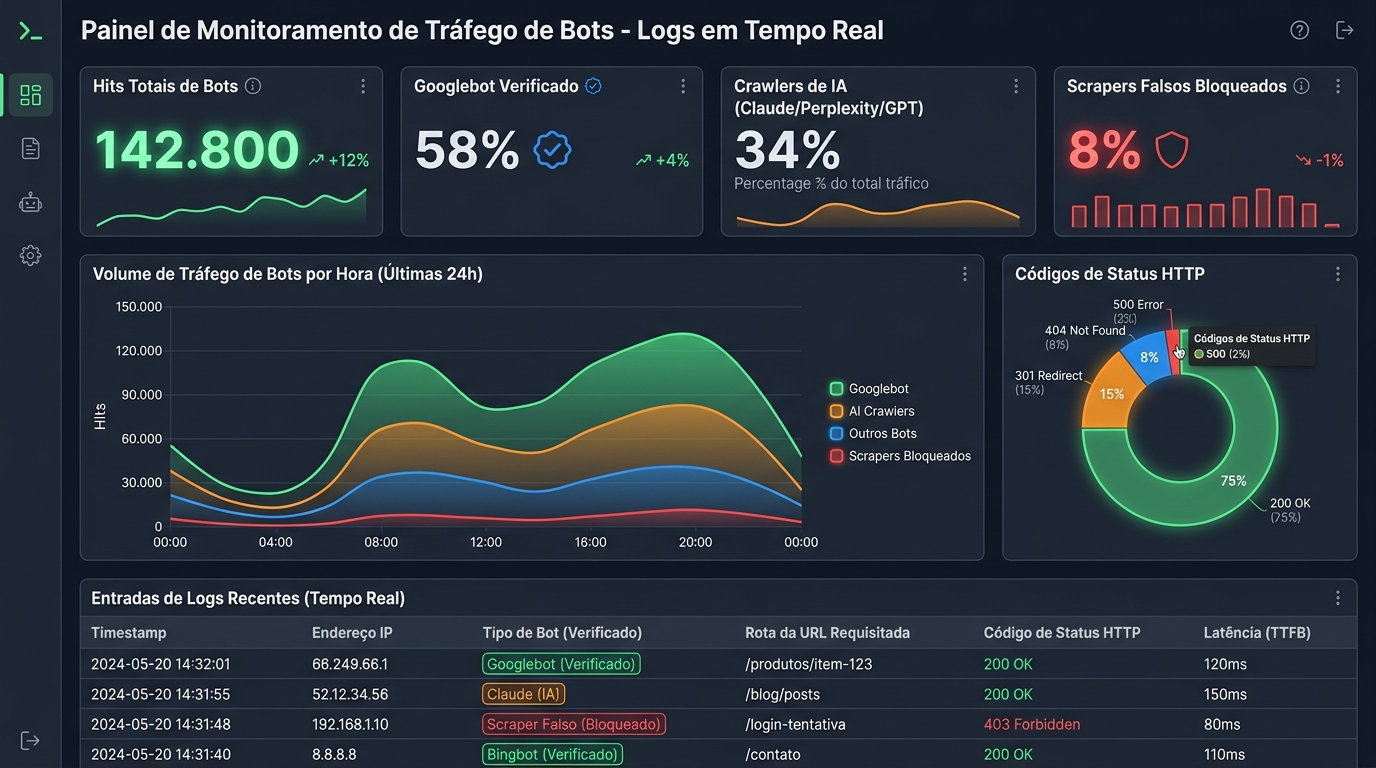
A inteligência analítica extraída dos logs deve ser revertida imediatamente em proteção de infraestrutura e otimização de tráfego. Ao identificar que robôs hostis como o Bytespider estão saturando o servidor ou que scrapers falsificados estão burlando as regras, a equipe técnica deve acionar bloqueios em nível de Web Application Firewall (WAF) ou Nginx.
O monitoramento contínuo em dashboards operacionais transforma a equipe de SEO em parceira direta da engenharia de confiabilidade de sites (SRE).
7.1 Configuração de Rate Limiting e Bloqueio no Nginx com Módulos Geo e Map
Para conter agentes de raspagem predatória sem afetar o Googlebot legítimo, utilizamos os módulos `map` e `limit_req_zone` do Nginx. Essa configuração aplica limites estritos de requisições por segundo para User-Agents não autorizados, enquanto concede passagem livre aos buscadores certificados:
# [NGINX WAF & RATE LIMITING]
# No contexto http do nginx.conf:
map $http_user_agent $is_aggressive_bot {
    default 0;
    ~*(Bytespider|CCBot|Amazonbot) 1;
}

# Cria zona de rate limiting dedicada para bots agressivos (máx 1 req/segundo)
limit_req_zone $binary_remote_addr zone=ai_bot_limit:10m rate=1r/s;

server {
    location / {
        # Se for um scraper predatório, aplica estrangulamento imediato
        if ($is_aggressive_bot) {
            limit_req zone=ai_bot_limit burst=3 nodelay;
        }

        # Bloqueio sumário para bots que falsificam Googlebot mas falham no rDNS
        # (Integrado com listas dinâmicas geradas pelo script Python via Fail2ban)
        try_files $uri $uri/ /index.php?$args;
    }
}
7.2 Sistema de Alertas Automáticos via Webhook para Slack e Discord
Sempre que o pipeline de logs detecta uma elevação súbita na taxa de erros HTTP 500 durante visitas do Googlebot ou uma invasão de bots falsificados, um alerta deve ser despachado instantaneamente para os canais de plantão da equipe. A rotina a seguir utiliza webhooks do Slack para notificar o time sobre anomalias críticas de rastreamento:
# [PYTHON WEBHOOK ALERT]
import requests

def send_bot_alert_to_slack(webhook_url: str, alert_title: str, message_body: str):
    """Envia notificação estruturada para o canal de engenharia no Slack."""
    payload = {
        "text": f"🚨 *{alert_title}*",
        "attachments": [
            {
                "color": "#EF4444",
                "text": message_body,
                "footer": "Sistema de Observabilidade de SEO & LogOps 2026"
            }
        ]
    }
    resp = requests.post(webhook_url, json=payload, timeout=10)
    if resp.status_code == 200:
        logging.info("Alerta de log enviado com sucesso ao Slack.")
    else:
        logging.error(f"Erro ao disparar webhook: {resp.status_code}")
8. Perguntas Frequentes sobre Análise de Logs e Bots de IA (FAQ)
8.1 Por que a análise de logs de servidor é mais confiável que o Google Analytics ou o Search Console?
O Google Analytics depende da execução de JavaScript no navegador do usuário e descarta automaticamente o tráfego de crawlers, tornando-se completamente cego para a atividade de robôs. Já o Search Console apresenta dados amostrados com até 72 horas de latência e restritos ao ecossistema do Google. Os arquivos de log do servidor registram 100% das requisições HTTP em nível de socket de rede no instante exato em que ocorrem, incluindo bots de IA como ClaudeBot e PerplexityBot.
8.2 Como validar se uma requisição assinada como Googlebot ou ClaudeBot é autêntica?
A autenticidade deve ser comprovada através do processo de Reverse DNS (rDNS) duplo. Primeiro, executa-se uma consulta PTR sobre o IP de origem para obter o hostname oficial (que deve terminar em domínios como `.googlebot.com`, `.google.com` ou `.anthropic.com`). Em seguida, realiza-se uma consulta Forward A sobre o hostname resolvido: se o IP retornado coincidir exatamente com o IP original da requisição, o bot é legítimo; caso contrário, trata-se de spoofing fraudulento.
8.3 Qual é a diferença entre bots de treinamento (GPTBot) e bots de recuperação ao vivo (OAI-SearchBot, PerplexityBot)?
Bots de treinamento como o GPTBot varrem o conteúdo em lotes massivos para alimentar conjuntos de dados de pré-treinamento de modelos fundacionais, sem gerar tráfego imediato para o site. Já bots de recuperação como o OAI-SearchBot e o PerplexityBot operam no modelo de busca em tempo real (RAG), visitando URLs específicas sob demanda para responder perguntas de usuários. Essa atividade de RAG ao vivo gera citações destacadas e cliques diretos de alto valor para o domínio.
8.4 Como bots de inteligência artificial afetam o Crawl Budget do Googlebot?
Embora o Crawl Budget do Google seja determinado pela capacidade e demanda do seu site no ecossistema do Google, crawlers agressivos de IA consomem largura de banda, conexões simultâneas e memória do servidor web. Se esses bots elevarem a latência média (TTFB) ou causarem erros transitórios HTTP 503, o Googlebot reduzirá preventivamente o ritmo de rastreamento para evitar a sobrecarga do servidor. Essa desaceleração compromete diretamente a velocidade de indexação de páginas comerciais e novos artigos.
8.5 É possível bloquear scrapers de IA hostis sem prejudicar o ranqueamento orgânico no Google?
Sim. É possível configurar regras granulares no arquivo robots.txt desautorizando User-Agents específicos (como Bytespider, CCBot ou GPTBot) enquanto se mantém a permissão irrestrita para o Googlebot e o Bingbot. Adicionalmente, em nível de infraestrutura (Nginx ou WAF Cloudflare), pode-se aplicar rate limiting restrito e bloqueio de IPs não autenticados via rDNS para impedir raspagens abusivas sem afetar os buscadores.
8.6 Quais campos adicionais devem ser configurados no formato de log do Nginx para auditorias avançadas de SEO?
Além dos campos padrão do formato combined (IP, data, rota, status e user-agent), recomenda-se adicionar as variáveis `$request_time` (tempo total de processamento em segundos), `$upstream_response_time` (latência do backend/PHP/Node.js) e `$ssl_protocol`. O monitoramento do tempo de resposta por rota permite identificar páginas lentas que desperdiçam recursos de rastreamento dos robôs e prejudicam a experiência do usuário.
8.7 Como construir um pipeline contínuo de análise de logs em Python sem sobrecarregar a memória do servidor?
A melhor prática é utilizar leitura de arquivos em fluxo (streaming via geradores em Python) acoplada a engines colunares de alto desempenho como o DuckDB. Essa abordagem processa logs compactados (.gz) linha por linha ou em blocos em disco, evitando carregar gigabytes de texto na memória RAM e permitindo consultas SQL analíticas em segundos.
9. Conclusão: A Transição para LogOps e Observabilidade de SEO em 2026
A convergência entre a inteligência artificial generativa e a busca orgânica tradicional encerrou definitivamente a era do SEO baseado em adivinhação e painéis estáticos. Em 2026, a análise de logs de servidor não é mais um exercício esporádico de resolução de crises, mas uma disciplina permanente de engenharia de confiabilidade de busca (Search Reliability Engineering).
Ao dominar a anatomia dos logs do Nginx, validar bots com rigor criptográfico via Reverse DNS e automatizar auditorias de Crawl Budget com Python e DuckDB, você transforma a sua infraestrutura em uma fortaleza. Você protege os dados e a estabilidade dos servidores contra raspadores predatórios, enquanto constrói o tapete vermelho de alta velocidade para que o Googlebot, Claude e Perplexity encontrem, citem e posicionem o seu conteúdo no topo da web.