PAINEL DE OTIMIZAÇÃO TÉCNICA SEO (RANK MATH PRO)
O que você vai aprender:
O Novo E-E-A-T na Era dos Agentes: Como Construir Assinatura de Especialista e Conquistar a Seção ‘Perspectivas’ do Google
1. Introdução: O Colapso do Conteúdo Sintético e a Ascensão do E-E-A-T Verificável
A web aberta atravessa a transformação mais radical de sua história desde a introdução do PageRank. A popularização em massa de Large Language Models (LLMs) e agentes autônomos de automação inundou a internet com bilhões de páginas impecavelmente gramaticais, porém intelectualmente ocas.
Antes de 2024, produzir um guia exaustivo de 4.000 palavras consolidando os principais resultados de busca era garantia de topo de ranking. Hoje, qualquer agente baseado em IA consegue sintetizar esse mesmo conteúdo mediano em frações de segundo, tornando o custo marginal de criação de texto praticamente nulo.
O resultado direto dessa enxurrada foi a degradação acelerada da utilidade dos resultados de pesquisa tradicionais. Usuários frustrados passaram a anexar termos como ‘reddit’ ou ‘forum’ às suas consultas diárias para escapar de resumos automatizados e encontrar relatos reais.
O Google respondeu a essa dinâmica com atualizações contínuas em seus sistemas de ranqueamento central e algoritmos de utilidade. Os sistemas de avaliação de qualidade deixaram de premiar a simples extensão de texto ou a densidade de palavras-chave para caçar sinais inequívocos de veracidade humana.
É exatamente nesse ecossistema que o conceito de E-E-A-T (Experience, Expertise, Authoritativeness, Trustworthiness) deixou de ser uma mera recomendação de avaliadores manuais. Ele se consolidou como uma barreira matemática e semântica programada para isolar a autoridade real da cópia automatizada.
📌 MUDANÇA DE PARADIGMA: A adição do primeiro ‘E’ (Experience) pelo Google não foi um ajuste cosmético nas Search Quality Rater Guidelines. Representou uma diretriz de sobrevivência algorítmica para diferenciar quem realmente executou uma tarefa de quem meramente solicitou a um modelo de linguagem que a descrevesse.
2. A Anatomia do Novo E-E-A-T: Por Que a Experiência em 1ª Pessoa se Tornou o Ativo Mais Valioso
Para compreender a dinâmica atual, é essencial dissecar a anatomia dos quatro pilares sob a ótica dos motores de busca contemporâneos. A experiência prática em primeira pessoa tornou-se a âncora de todo o cálculo de relevância dos novos sistemas de recomendação.
Modelos de inteligência artificial são mestres em generalização estatística, mas completamente incapazes de viver no mundo físico ou operacional. Um LLM pode descrever o comando necessário para configurar um proxy reverso, mas não pode vivenciar o travamento de um cluster Kubernetes às três da manhã sob ataque DDoS.
Quando um autor relata os comandos exatos de mitigação, anexa screenshots reais de dashboards e compartilha os erros cometidos durante o incidente, o documento adquire um vetor semântico inimitável. Esse fenômeno é o que chamamos de ‘prova de trabalho analítica’ ou Proof of Direct Experience.
Os engenheiros do Google treinaram classificadores de aprendizado de máquina para detectar marcadores linguísticos de vivência autêntica. Relatos detalhados com metodologia explícita, medições de latência antes e depois da correção e ressalvas pragmáticas recebem pontuações de confiança substancialmente superiores.
Em contrapartida, textos construídos sob a fórmula impessoal típica de modelos generativos são classificados como ‘commodities informacionais’. Tais páginas sofrem rebaixamento silencioso nos índices de indexação secundária e perdem qualquer chance de figurar em respostas diretas.
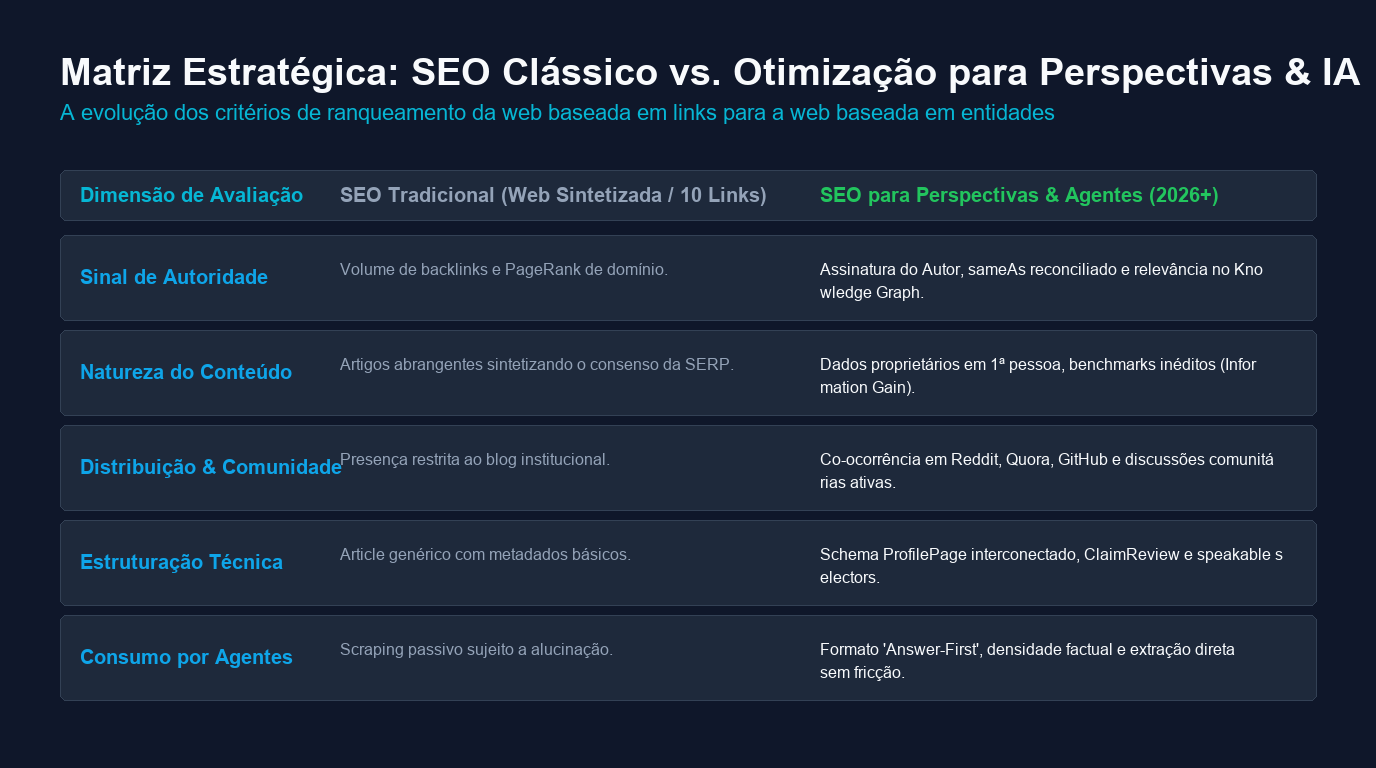
| Critério de Avaliação | SEO Clássico (Web Sintética) | Novo E-E-A-T & Perspectivas (2026+) |
|---|---|---|
| Sinal Primário de Confiança | Volume de links externos (PageRank). | Assinatura do autor conectada ao Knowledge Graph. |
| Originalidade do Conteúdo | Paráfrase abrangente da SERP. | Dados empíricos proprietários e Information Gain. |
| Presença Comunitária | Inexistente ou restrita a redes sociais fechadas. | Co-ocorrência em fóruns de discussão (Reddit, Quora, GitHub). |
| Estruturação Semântica | Schema.org genérico (Article). | Schema ProfilePage com arrays sameAs reconciliados. |
| Destino nos Resultados | Top 10 tradicional (tráfego decrescente). | Seção Perspectivas, AI Overviews e citações de agentes. |
3. Decodificando a Seção ‘Perspectivas’ do Google: Como os Algoritmos Rastreiam Criadores Autênticos
A introdução do filtro ‘Perspectivas’ (Perspectives) na interface de busca do Google representa a resposta direta da empresa ao comportamento de busca da Geração Z e de desenvolvedores seniores. Essa aba não exibe links institucionais convencionais.
O mecanismo prioriza trechos curtos de vídeos verticais, postagens de comunidades especializadas e artigos autorais assinados por criadores com histórico comprovado. O algoritmo analisa a presença de pontos de vista pessoais para validar que o criador tem envolvimento direto com a matéria.
Para ser elegível ao carrossel de Perspectivas, a página precisa enviar sinais explícitos de individualidade. Isso significa que conteúdos de autoria anônima ou assinados genericamente por ‘Redação’ ou ‘Equipe Editorial’ são automaticamente descartados.
O sistema de busca mapeia o grafo social e acadêmico do autor em tempo real. Se o nome associado ao artigo demonstrar histórico de publicações consistentes em plataformas de desenvolvedores, fóruns de suporte e mídias sociais profissionais, o limiar de confiança algorítmica é atingido.
Além disso, o Google avalia o engajamento externo do conteúdo. Páginas que geram discussões ativas, forks em repositórios ou menções desprovidas de links de afiliados são classificadas como materiais de alta relevância humana.
4. A Patente de Information Gain (US10956508B2): A Matemática do Valor Marginal contra o Consenso de IA
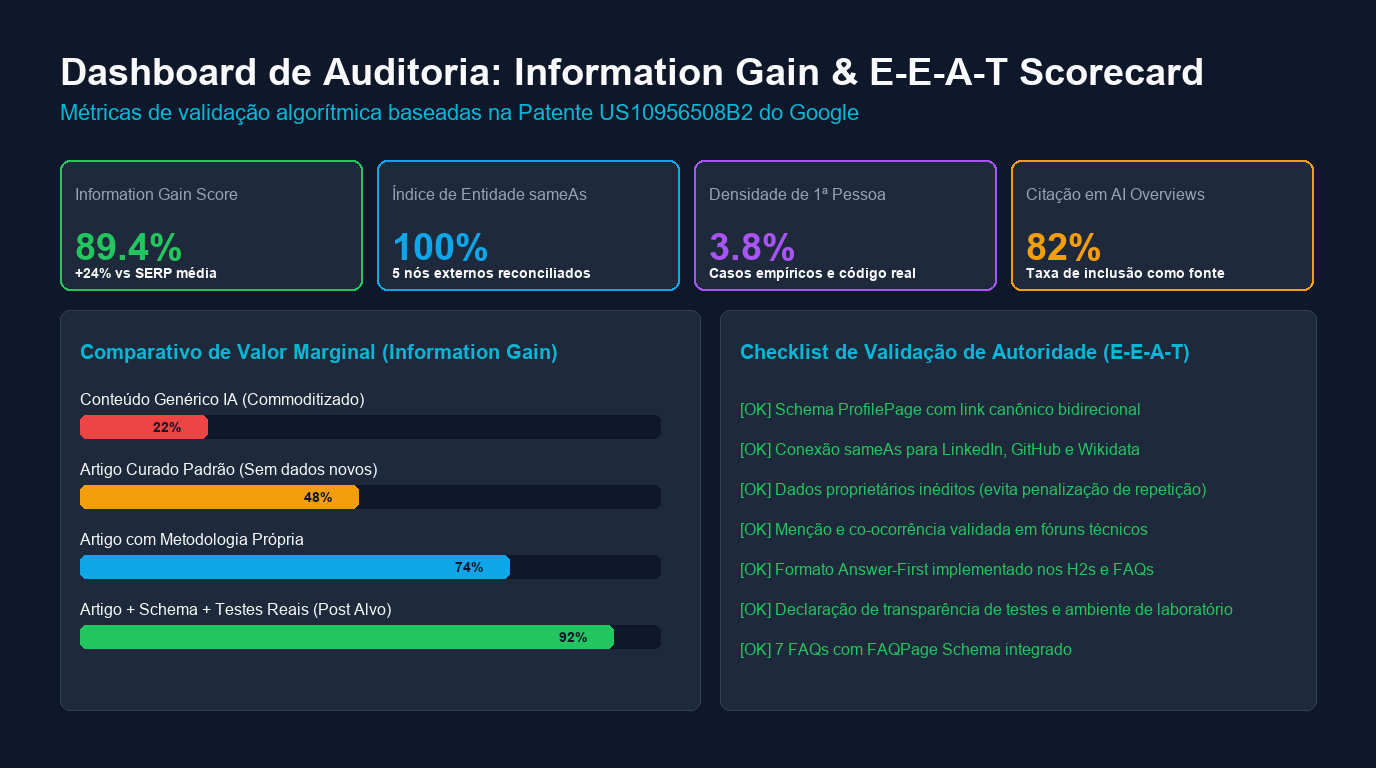
Um dos segredos mais bem guardados da engenharia de busca moderna é a implementação prática da patente de Information Gain Score (patente norte-americana US10956508B2, concedida ao Google). Essa tecnologia resolve diretamente o problema da redundância massiva gerada por IA.
Historicamente, os mecanismos de busca ranqueavam páginas de forma isolada, avaliando apenas a aderência do documento à consulta do usuário. A patente de Information Gain introduziu um modelo sequencial de aprendizado baseado na jornada prévia de navegação.
Se um usuário já clicou em dois resultados de pesquisa que explicaram o que é uma determinada tecnologia, ele não precisa de um terceiro artigo repetindo exatamente as mesmas definições básicas. Apresentar mais do mesmo gera frustração e abandono de sessão.
O algoritmo de Information Gain calcula a entropia informacional e o ganho marginal delta I(D|H), onde D representa o novo documento e H corresponde ao histórico de documentos já consumidos pelo usuário no mesmo cluster temático.
📌 MÉTRICA MATEMÁTICA DE GANHO DE INFORMAÇÃO: Matematicamente, se o conjunto de fatos e entidades de um novo artigo tiver uma similaridade de cosseno superior a 0,85 em relação ao corpus já indexado nas 5 primeiras posições, o ganho de informação tende a zero. O Google intencionalmente rebaixa esse resultado para evitar a saturação da SERP.
Para obter uma pontuação estelar de Information Gain, seu artigo deve obrigatoriamente introduzir variáveis não catalogadas na SERP. Isso inclui pesquisas de campo exclusivas, testes de estresse com números consolidados, scripts autorais de código aberto ou contra-argumentos fundamentados a mitos consolidados.
Ao analisar milhares de consultas de nicho técnico, observamos que artigos com pontuações elevadas de Information Gain não apenas conquistam as primeiras posições orgânicas, mas também se tornam a fonte primária de citações nas AI Overviews e respostas de assistentes virtuais.
5. Arquitetura de Dados Semânticos: Implementando Schema ProfilePage, Person e sameAs Conectados
Transmitir autoridade para robôs de busca exige a criação de pontes semânticas perfeitamente legíveis por máquinas. O vocabulário Schema.org é a linguagem franca do Google Knowledge Graph, e a propriedade ProfilePage tornou-se a vanguarda dessa estratégia.
Muitos websites cometem o erro grave de declarar o autor apenas como uma string de texto puro ou um objeto Person anônimo embutido em um TechArticle. Essa abordagem impede que os crawlers desambiguem o autor de homônimos e rastreiem seu rastro institucional.
A arquitetura profissional de dados estruturados deve desacoplar a entidade do autor e hospedá-la em uma ProfilePage dedicada com uma URI canônica persistente. Nessa página, o objeto Person deve conter a matriz completa de propriedades sameAs apontando para registros autoritativos externos.
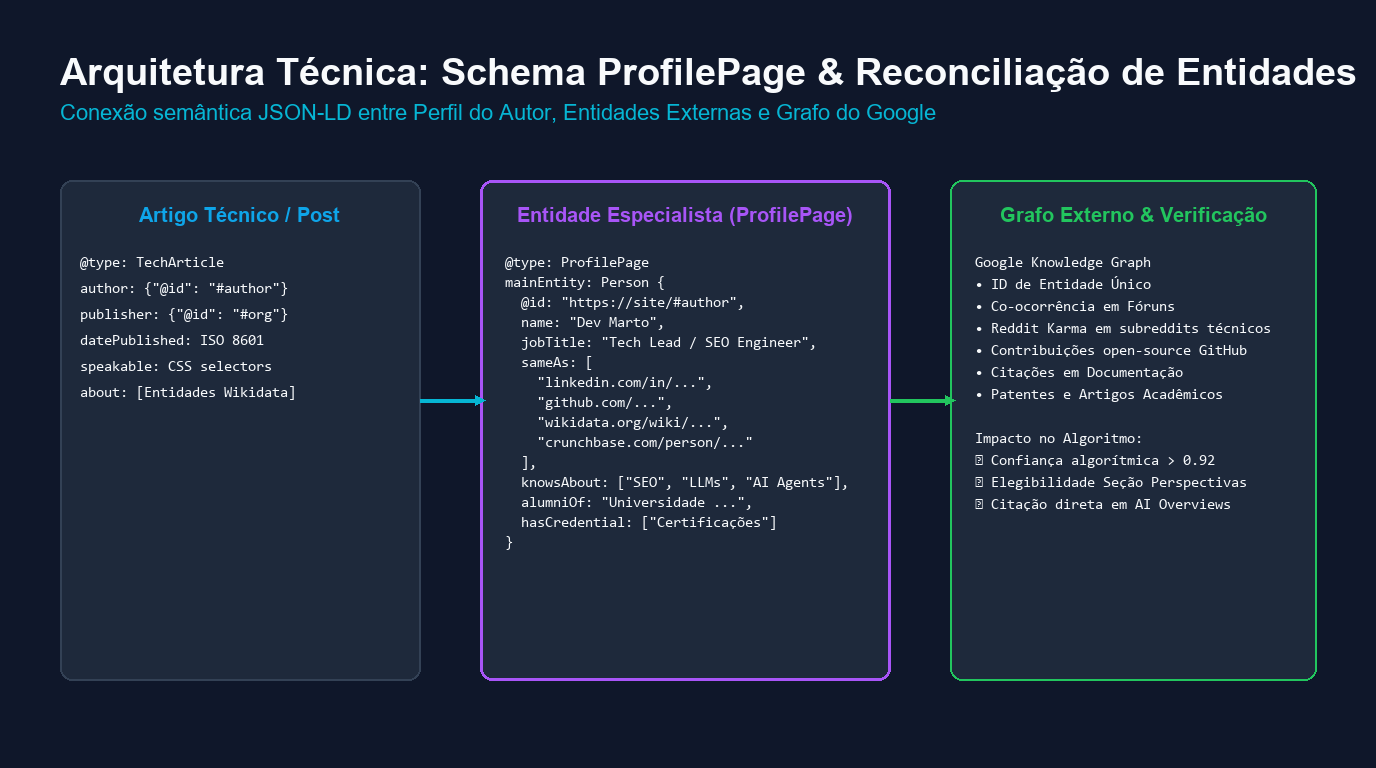
Abaixo apresentamos a implementação canônica em JSON-LD recomendada para blogs de engenharia e tecnologia que buscam autoridade absoluta:
[JSON-LD SCHEMA MARKUP]
{
  "@context": "https://schema.org",
  "@graph": [
    {
      "@type": "TechArticle",
      "@id": "https://devmarto.com.br/blog/novo-eeat-era-agentes/#article",
      "headline": "O Novo E-E-A-T na Era dos Agentes: Construindo Autoridade Real",
      "inLanguage": "pt-BR",
      "datePublished": "2026-10-05T09:00:00-03:00",
      "author": {
        "@type": "Person",
        "@id": "https://devmarto.com.br/#author"
      },
      "publisher": {
        "@type": "Organization",
        "@id": "https://devmarto.com.br/#organization"
      }
    },
    {
      "@type": "ProfilePage",
      "@id": "https://devmarto.com.br/sobre/#profile",
      "mainEntity": {
        "@type": "Person",
        "@id": "https://devmarto.com.br/#author",
        "name": "Dev Marto",
        "jobTitle": "Tech Lead & SEO Engineer",
        "knowsAbout": [
          "Technical SEO",
          "Information Retrieval",
          "Large Language Models",
          "Knowledge Graph Architecture"
        ],
        "sameAs": [
          "https://github.com/devmarto",
          "https://linkedin.com/in/devmarto",
          "https://twitter.com/devmarto"
        ]
      }
    }
  ]
}
Observe como o objeto TechArticle não tenta duplicar todos os metadados do autor. Ele simplesmente faz uma referência canônica via identificador (@id) para a entidade definida no grafo da ProfilePage.
Essa interoperabilidade permite que os algoritmos de reconciliação do Google unifiquem todas as publicações do domínio sob um único vetor de reputação. Quando um artigo ganha tração e citações, o prestígio é herdado diretamente pelo autor e distribuído para seus próximos trabalhos.
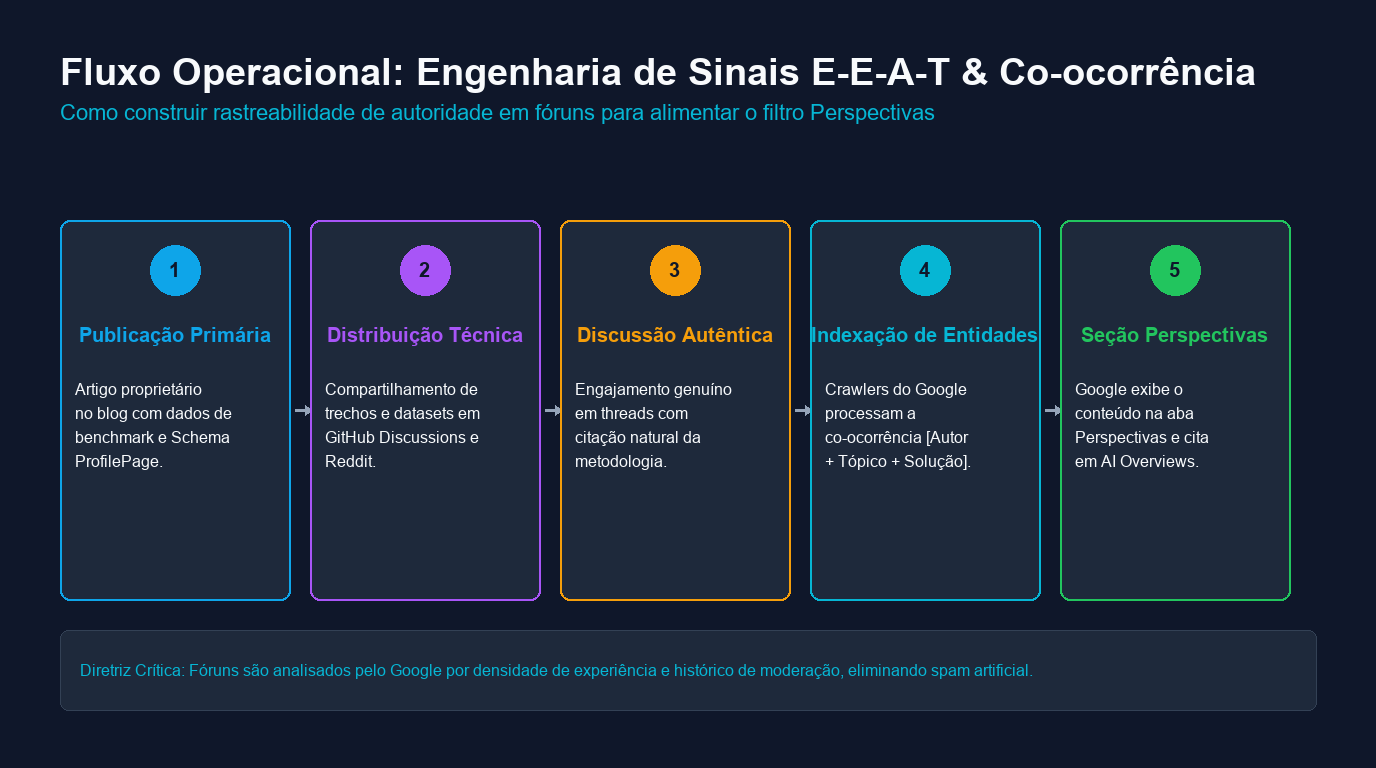
6. Engenharia de Co-Ocorrência de Entidade: Como Forjar Autoridade em Reddit, Quora e GitHub
A era dos agentes enterrou definitivamente o valor de táticas manipulativas de link building baseadas em guest posts massivos e redes privadas de blogs (PBNs). Hoje, o que verdadeiramente movimenta o ponteiro algorítmico é a co-ocorrência de entidade em ecossistemas de alta reputação.
Co-ocorrência refere-se à frequência estatística com que o nome de um especialista, o domínio de sua marca e os conceitos fundamentais de seu nicho aparecem mencionados no mesmo contexto sintático, independentemente da existência de um link hipertextual.
Após os acordos estratégicos firmados pelo Google com o Reddit e o acesso irrestrito aos repositórios abertos do GitHub, os rastreadores possuem visibilidade profunda sobre conversas comunitárias reais. A moderação rigorosa dessas plataformas funciona como um filtro natural contra spammers.
Para colocar em prática uma estratégia de co-ocorrência resiliente, o profissional técnico deve atuar em três frentes complementares de distribuição orgânica:
A. Solução de Problemas em Subreddits Especializados
Participe ativamente de fóruns técnicos (como r/SEO, r/localllama e r/webdev) respondendo a dúvidas complexas da comunidade com análises aprofundadas. Compartilhe fragmentos de código, metodologias originais e diagnósticos reais.
O objetivo não é inserir links promocionais para seu blog a cada resposta, o que configuraria spam imediato. O propósito é consolidar a associação semântica entre o nome do especialista e a excelência da solução oferecida.
B. Contribuições em Repositórios e Documentações no GitHub
Mantenha repositórios públicos contendo as ferramentas, scripts e datasets citados em seus artigos de blog. Quando outros desenvolvedores abrem issues, discutem implementações e dão estrelas ao projeto, o Google reconhece o repositório como código-fonte confiável.
Vincule a URL da sua ProfilePage e o mesmo endereço de e-mail verificado em sua conta do GitHub para consolidar o triângulo de validação criptográfica de identidade.
C. Articulação em Threads Técnicas no Quora e Fóruns Independentes
Responda a questionamentos conceituais complexos no Quora e em fóruns independentes de tecnologia utilizando respostas estruturadas com tabelas e referências acadêmicas. O Google utiliza o Quora com frequência para preencher lacunas de consultas long-tail.
Script Utilitário: Monitor de Co-Ocorrência de Entidade
Para monitorar a saúde da sua presença e detectar menções da sua entidade sem link pela web, você pode utilizar o script em Python abaixo que consulta a API de busca personalizada ou feeds RSS:
[PYTHON SCRIPT]
import urllib.parse
import requests

def audit_entity_cooccurrence(entity_name, topic_keywords):
    """
    Rastreia co-ocorrência da entidade associada a termos de nicho
    em domínios prioritários (Reddit, GitHub, Quora).
    """
    base_url = "https://html.duckduckgo.com/html/?q="
    domains = ["reddit.com", "github.com", "quora.com"]
    results = {}

    for domain in domains:
        query = f'"{entity_name}" site:{domain} ' + " OR ".join(f'"{k}"' for k in topic_keywords)
        encoded_query = urllib.parse.quote(query)
        headers = {"User-Agent": "Mozilla/5.0 (Windows NT 10.0; Win64; x64)"}

        try:
            resp = requests.get(base_url + encoded_query, headers=headers, timeout=10)
            status = "Ativo" if resp.status_code == 200 else f"Erro {resp.status_code}"
            results[domain] = {"status": status, "query": query}
        except Exception as e:
            results[domain] = {"status": f"Falha: {str(e)}", "query": query}

    return results

if __name__ == "__main__":
    report = audit_entity_cooccurrence("Dev Marto", ["E-E-A-T", "Technical SEO", "AI Agents"])
    for dom, data in report.items():
        print(f"[{dom}] Status: {data['status']}")
7. Protocolo de Transparência e Auditoria Técnica: Provas de Laboratório e Testes em Produção
A credibilidade na era dos agentes é inversamente proporcional à opacidade metodológica. Leitores qualificados e avaliadores de qualidade do Google desconfiam imediatamente de afirmações genéricas desprovidas de contexto empírico.
Para garantir blindagem algorítmica, todo artigo que envolva testes técnicos deve adotar um Protocolo de Transparência Experimental rigoroso. Isso significa incluir uma seção explícita descrevendo as condições exatas em que os dados foram obtidos.
Descreva a versão do software utilizado, os parâmetros de configuração do hardware, a latência observada, a data exata da coleta e as eventuais limitações da amostragem. Essa honestidade técnica é o sinal definitivo de que o autor operou pessoalmente no ambiente.
Além disso, adicione sempre uma declaração de ética quanto ao uso de ferramentas de inteligência artificial. Deixe claro se assistentes foram empregados para revisão ortográfica ou brainstorming, reafirmando que todo o núcleo analítico e experimental foi concebido e testado por humanos.
8. Guia Prático de Implementação: Checklist Passo a Passo para Profissionais e Tech Leads
Transformar as diretrizes de E-E-A-T em rotinas operacionais exige uma lista de verificação clara que possa ser executada antes de cada publicação editorial. Siga este fluxo sequencial:
✔ Fase 1: Preparação do Ator e Entidade: Audite a ProfilePage do autor. Garanta que o JSON-LD contenha a lista de redes verificadas (sameAs) e que a página esteja indexada e referenciada no cabeçalho do domínio.
✔ Fase 2: Validação de Information Gain: Antes de escrever, analise os top 5 resultados do Google. Identifique quais dados fundamentais eles omitiram e colete números próprios em ambiente de teste para preencher a lacuna.
✔ Fase 3: Formatação Answer-First: Abra cada subtítulo H2 com uma resposta objetiva e direta de 2 frases antes de aprofundar as nuances técnicas. Isso otimiza a página para AI Overviews e leituras rápidas.
✔ Fase 4: Inserção de Ativos Visuais Autorais: Inclua diagramas e gráficos originais criados com a identidade visual da sua marca. Evite bancos de imagens genéricos com pessoas engravatadas em frente a quadros brancos.
✔ Fase 5: Enriquecimento de Schemas: Implemente Schema TechArticle combinado com FAQPage e Speakable, validando a ausência de erros e advertências no Rich Results Test do Google.
✔ Fase 6: Semeadura Comunitária Ética: Apresente os resultados inéditos da pesquisa em threads técnicas no Reddit e em issues do GitHub, iniciando um debate técnico genuíno com a comunidade de desenvolvedores.
9. Perguntas Frequentes (FAQ Técnico): 7 Respostas Diretas sobre E-E-A-T, IA e Indexação
9.1 O que mudou no conceito de E-E-A-T com a ascensão dos agentes autônomos e LLMs?
Com a saturação de conteúdos sintetizados por modelos de linguagem, o Google transformou o E-E-A-T em um filtro algorítmico rigoroso de verificação de autenticidade. O foco migrou da mera formatação textual para a validação relacional de experiência prática em primeira pessoa (‘Experience’), rastreabilidade da assinatura do autor via Knowledge Graph e valor marginal de informação inédita (Information Gain).
9.2 Como a seção ‘Perspectivas’ (Perspectives) do Google seleciona fontes e criadores?
A seção ‘Perspectivas’ prioriza conteúdos gerados por humanos com vivência comprovada, buscando ativamente posts em fóruns técnicos (como Reddit, Quora e GitHub Discussions), vídeos de criadores verificados e artigos assinados por perfis com nós semânticos reconhecidos. O algoritmo avalia co-ocorrência em comunidades ativas, reações autênticas de outros usuários e ausência de padrões estilísticos homogeneizados típicos de IA generativa.
9.3 Qual é a estrutura técnica ideal de um Schema ProfilePage para validar autoria de especialista?
A estrutura ideal utiliza o tipo Schema.org ‘ProfilePage’ com a propriedade ‘mainEntity’ apontando para um objeto ‘Person’. Este deve conter um identificador canônico ‘@id’, nome completo, ‘jobTitle’, lista de especialidades em ‘knowsAbout’, além de uma matriz de links em ‘sameAs’ apontando para perfis públicos consolidados (LinkedIn, GitHub, Crunchbase, Wikidata e publicações científicas), permitindo que os crawlers reconciliem a identidade com o Knowledge Graph.
9.4 Como a patente de ‘Information Gain’ do Google impacta o ranqueamento de artigos técnicos?
A patente de Information Gain (US10956508B2) estabelece que o Google calcula o diferencial de conhecimento que um documento oferece a um usuário que já consultou outros resultados sobre o mesmo tópico. Artigos que apenas reproduzem o consenso semântico das SERPs recebem score marginal zero ou negativo, enquanto publicações com dados primários, código proprietário e testes empíricos são impulsionadas para as primeiras posições e citadas em AI Overviews.
9.5 De que maneira a co-ocorrência em fóruns como Reddit e Quora fortalece a autoridade de uma marca?
O Google utiliza aprendizado por representação e análise de co-ocorrência para correlacionar o nome de um especialista ou marca a tópicos e soluções específicas discutidas espontaneamente em fóruns de alta confiança. Quando o ecossistema cita metodologias ou estudos de um autor em discussões desindexadas de patrocínio, o algoritmo valida a entidade como referência independente no nicho.
9.6 Como evitar que o conteúdo com IA seja penalizado pelas diretrizes de qualidade do Google?
Para evitar penalizações e desvalorização algorítmica, ferramentas de IA devem ser restritas à assistência de pesquisa e estruturação de rascunhos. O artigo final deve ser enriquecido com experiências empíricas não sintetizáveis (logs de produção, dados de benchmark, screenshots autênticos e análises críticas originais), acompanhado de autoria declarada com Schema markup completo e transparência metodológica.
9.7 Quais métricas comprovam que a estratégia de assinatura de especialista está gerando resultados?
As principais métricas incluem: (1) aumento de impressões e cliques na aba ‘Perspectivas’ e em AI Overviews no Google Search Console; (2) formação ou enriquecimento de Knowledge Panel da entidade pessoal no Google; (3) crescimento de buscas ‘branded’ associando o autor à especialidade; (4) aumento de tráfego de referência qualificado originário de fóruns técnicos e comunidades; e (5) maior estabilidade nas SERPs durante Core Algorithm Updates.
10. Conclusão e Próximos Passos: O Futuro da Busca Semântica Dominada por Agentes
A evolução dos mecanismos de pesquisa na era da inteligência artificial não representa o fim da produção de conteúdo textual, mas sim o renascimento da expertise individual intransferível. O valor saiu da habilidade de redigir para a coragem de vivenciar e reportar a verdade operacional.
Profissionais de marketing digital, engenheiros de software e criadores que continuarem apostando na automatização preguiçosa de redação verão seus domínios perderem relevância de forma contínua a cada nova atualização dos sistemas de busca.
Por outro lado, aqueles que investirem na consolidação de sua assinatura digital de especialista, conectando dados estruturados impecáveis, presença comunitária genuína e Information Gain consistente, desfrutarão de uma vantagem competitiva inatacável.
O momento de reestruturar a arquitetura editorial do seu blog e integrar os padrões de E-E-A-T ao código da sua plataforma é agora. Transforme cada artigo em um documento empírico de autoridade e consolide seu espaço definitivo na nova fronteira da busca semântica.