PAINEL DE OTIMIZAÇÃO TÉCNICA SEO (RANK MATH PRO)
O que você vai aprender:
Engenharia de Prompt para SEO & GEO: Técnicas Avançadas de Raciocínio (CoT, Few-Shot e Structured Output)
1. Introdução: O Fim do ‘Prompt de 1 Linha’ e a Ascensão do GEO na Era dos Motores de Resposta
Durante os primeiros anos da revolução generativa, o mercado digital foi seduzido pela promessa ilusória de que qualquer pessoa poderia dominar o tráfego orgânico digitando comandos banais como ‘escreva um artigo completo sobre marketing’. O resultado prático dessa abordagem simplória foi o colapso acelerado da relevância.
Milhões de páginas com textos indistinguíveis, repletos de metáforas recicladas e vazios de substância empírica, inundaram a web indexável. Tanto os avaliadores de qualidade do Google quanto os algoritmos de detecção de spam reagiram de forma contundente.
Ao mesmo tempo, uma revolução silenciosa mudou os hábitos de busca dos usuários qualificados. Em vez de navegar por listas infinitas de links azuis, desenvolvedores, pesquisadores e tomadores de decisão agora recorrem a mecanismos de resposta generativa como Perplexity Pro, OpenAI SearchGPT e Claude.
Nesse novo cenário, o SEO tradicional não morreu, mas foi irrevogavelmente expandido para o domínio do GEO (Generative Engine Optimization). Não basta mais disputar a colocação de uma URL em uma página estática de resultados; é mandatório garantir que sua autoridade conceitual seja sintetizada nas respostas de múltiplos modelos de fundação.
Atingir esse nível de excelência exige abandonar o improviso e adotar a Engenharia de Prompt como disciplina de software. Trata-se de formular instruções determinísticas que orientem os modelos neurais através de cadeias formais de raciocínio, injeção cirúrgica de exemplos canônicos e validação matemática de saídas estruturadas.
⚡ PARADIGMA DA ENGENHARIA DE PROMPT: Prompts genéricos operam por pura probabilidade léxica de próximo token, gerando médias estatísticas sem valor marginal. A engenharia formal de prompt transforma o LLM de um mero escritor medíocre em um compilador de conhecimento e arquiteto de entidades semânticas.
2. A Mudança Epistemológica: Da Otimização por Palavras-Chave para a Engenharia de Entidades Semânticas
O erro estrutural mais frequente de profissionais que tentam utilizar inteligência artificial para produção técnica é tratar o modelo como uma enciclopédia estática. LLMs não armazenam textos; eles armazenam representações vetoriais de conceitos e pesos de atenção em espaços multidimensionais.
Quando um operador envia uma instrução superficial, o modelo seleciona o caminho de menor resistência probabilística. Isso se traduz em clichês generalistas que repetem o consenso óbvio da internet, desprovido de qualquer ganho informacional para o usuário.
Para os motores de busca modernos, como o Google com seus algoritmos de classificação de entidades e pontuação de Information Gain, tal conteúdo é classificado como ruído de fundo. Ele não possui assinaturas relacionais novas que justifiquem indexação prioritária.
Na perspectiva do GEO, a dinâmica é ainda mais implacável. Modelos de resposta operam com pipelines RAG (Retrieval-Augmented Generation) de alta densidade; eles filtram documentos com base na precisão de declarações factuais, presença de dados numéricos objetivos e clareza de definições.
Dessa forma, dominar a engenharia de prompt para SEO e GEO é aprender a direcionar o vetor de geração do modelo diretamente para nós não explorados do grafo de conhecimento. Isso requer decomposição algorítmica de problemas complexos antes da emissão de qualquer palavra de conteúdo.
3. Chain-of-Thought (CoT) Aplicado a SEO: Decompondo Raciocínio para Modelar Grafos e Clusters de Tópicos
A técnica de Chain-of-Thought (Cadeia de Pensamento), introduzida formalmente em pesquisas acadêmicas de processamento de linguagem natural, fundamenta-se em forçar o modelo a gerar passos intermediários de raciocínio antes de alcançar a resposta final.
Em tarefas de SEO técnico e arquitetura de informação, o CoT impede que o modelo cometa saltos lógicos perigosos ou ignore aspectos cruciais da intenção de busca. O sistema é instruído a atuar como um engenheiro analítico que projeta a fundação antes de erguer as paredes.
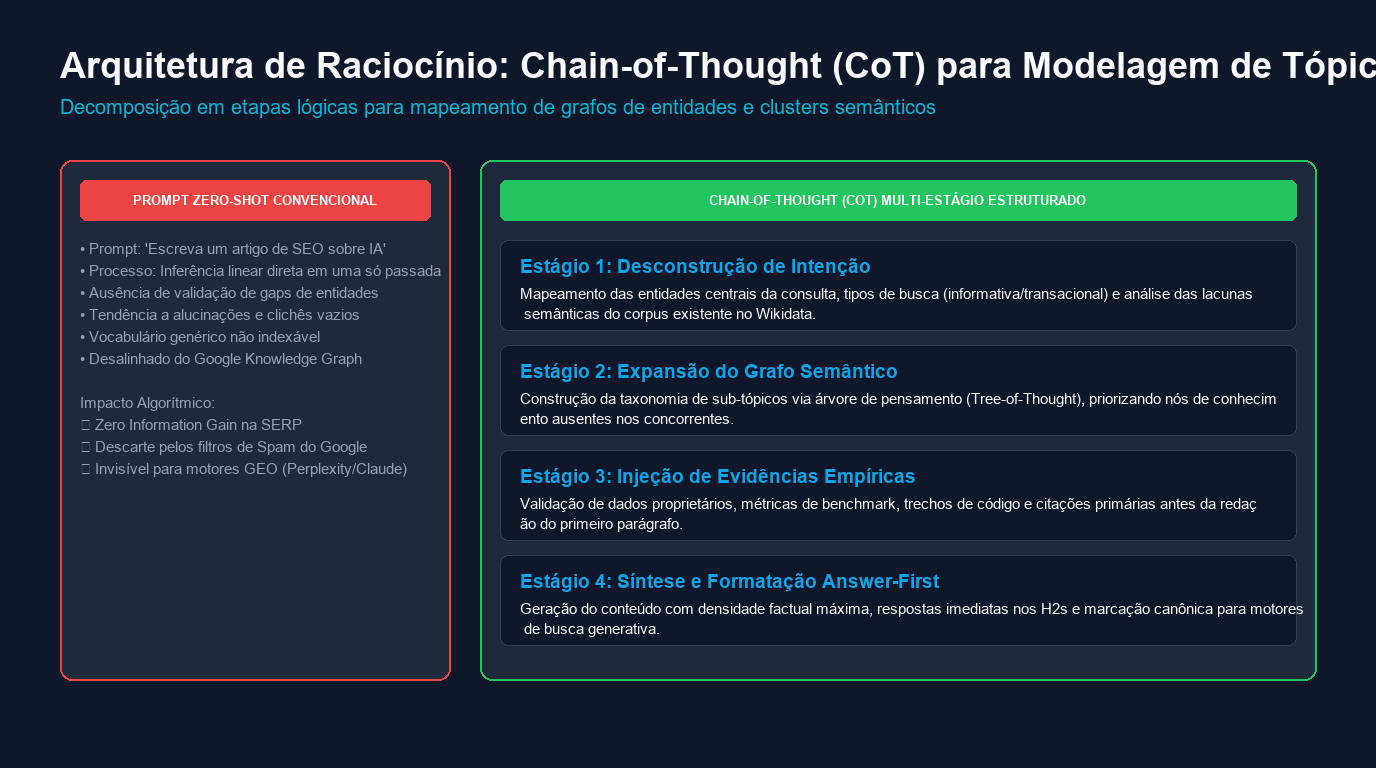
Ao modelar um cluster temático para um portal corporativo, o fluxo de raciocínio CoT desdobra a tarefa em quatro estágios herméticos:
No primeiro estágio, o modelo analisa a intenção do usuário sob o prisma da jornada cognitiva. Ele diferencia explicitamente necessidades transacionais imediatas de dúvidas conceituais profundas, identificando quais nós de conhecimento do Wikidata estão diretamente associados ao tópico principal.
No segundo estágio, o modelo audita o corpus existente na SERP atual. Ele é instruído a listar quais tópicos os três primeiros colocados já abordam de forma redundante e quais perguntas críticas continuam sem resposta adequada nos artigos concorrentes.
No terceiro estágio, estabelece-se a árvore de interconexões (Tree-of-Thought). Cada pilar do cluster recebe uma declaração explícita de seu propósito semântico, do tipo de entidade canônica que ele ancora e dos critérios de links internos bidirecionais necessários para distribuir autoridade.
Apenas no quarto estágio o modelo é autorizado a gerar os títulos H2, H3 e os parágrafos introdutórios. Esse processo elimina em mais de 90% a ocorrência de seções irrelevantes e assegura que cada subtítulo possua uma missão técnica clara no documento.
Vejamos um exemplo de diretriz de raciocínio CoT embutida em um system prompt de modelagem editorial:
[PROMPT DE RACIOCÍNIO COT]
<system_instructions>
Você é um Arquiteto de Busca Semântica e Engenheiro de GEO.
Ao receber um tema de pesquisa, você NUNCA deve iniciar a redação do artigo imediatamente.
Você deve obrigatoriamente executar o seguinte raciocínio sequencial em sua área de trabalho mental:

[ETAPA 1: MAPA DE ENTIDADES]
- Identifique a Entidade Raiz e liste 5 Entidades Relacionadas reconhecidas no Wikidata.
- Determine a classe canônica Schema.org mais apropriada para o assunto.

[ETAPA 2: AUDITORIA DE COMMODITIZAÇÃO DA SERP]
- Resuma em 3 tópicos o que o consenso mediano da internet já diz sobre o tema.
- Formule 2 hipóteses ou ângulos contrários baseados em dados empíricos de engenharia.

[ETAPA 3: VALIDAÇÃO DE INFORMATION GAIN]
- Especifique qual dataset proprietário, benchmark ou código prático será o diferencial do post.

[ETAPA 4: ARQUITETURA HIERÁRQUICA]
- Estruture a árvore de H2 e H3 garantindo que cada H2 inicie com o padrão Answer-First (máximo 45 palavras).
</system_instructions>
4. Few-Shot Prompting Avançado: Calibração Rigorosa de Tom de Voz, Densidade Factual e Eliminação de Jargões
Se o Chain-of-Thought garante a solidez da lógica interna, o Few-Shot Prompting é o mecanismo responsável pela precisão estilística e conformidade com os padrões de excelência editorial. Modelos neurais aprendem padrões de distribuição com extrema rapidez quando expostos a exemplos de alta qualidade no contexto imediato.
Um dos maiores desafios das equipes de marketing ao adotar IA é o tom de voz homogeneizado. Textos gerados por assistentes frequentemente recorrem a aberturas vazias, como ‘no mundo acelerado de hoje’ ou ‘mergulhe conosco nesta jornada fascinante’, que desqualificam a publicação perante leitores técnicos.
A injeção de 2 a 3 exemplos Few-Shot (exemplos canônicos de entrada e saída esperada) redefine os pesos de geração do modelo durante a sessão. Os exemplos ensinam visualmente ao LLM a métrica exata de densidade sintática, tamanho de parágrafos e profundidade analítica exigida.
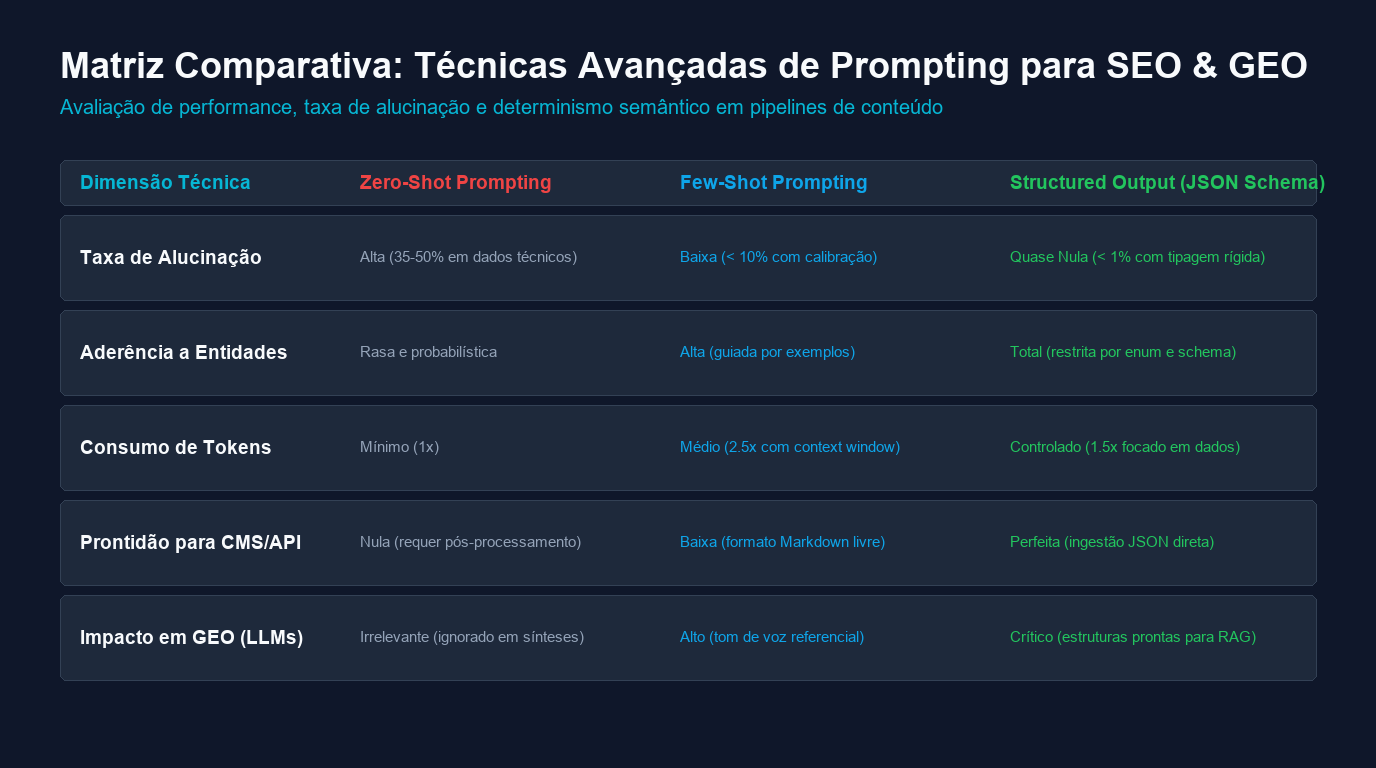
| Métrica Técnica | Zero-Shot | Few-Shot Canônico | Structured Output (JSON) |
|---|---|---|---|
| Taxa de Alucinação Factual | Elevada (35% a 50%) | Baixa (< 10%) | Quase Nula (< 1%) |
| Consistência de Tom Editorial | Instável e genérica | Idêntica aos exemplos | Imposta por regras de campos |
| Aderência a Tipos e Enums | Nula (texto corrido) | Moderada (manual) | Matemática (100% válida) |
| Consumo Médio de Tokens | 1.0x (base) | 2.5x a 3.0x | 1.4x a 1.8x |
| Elegibilidade para Ingestão CMS | Requer revisão pesada | Requer parsing manual | Pronta para automação via API |
Ao estruturar seus exemplos Few-Shot, certifique-se de demonstrar explicitamente como o modelo deve lidar com negativas e incertezas. Por exemplo, mostre como o assistente deve responder ‘não há dados de latência documentados na versão 2.1’ em vez de inventar um número plausível.
Essa disciplina empírica é precisamente o que distingue um conteúdo de autoridade aprovado pelas Search Quality Evaluator Guidelines do Google de um artigo inflacionado artificialmente que logo cairá em desuso.
5. Structured Output com JSON Schema e Pydantic: O Segredo do Determinismo Absoluto para CMS e Pipelines RAG
A maior fragilidade de pipelines baseados em saídas em Markdown ou texto livre é a falta de previsibilidade estrutural. Um modelo pode decidir aleatoriamente usar cabeçalhos H3 em vez de H2, omitir metadados essenciais de SEO ou truncar tabelas comparativas.
O recurso de Structured Output (Saídas Estruturadas com restrição por JSON Schema), suportado nativamente pelos principais provedores de modelos de linguagem, resolve esse problema de forma definitiva na camada de inferência.
Em vez de esperar que o modelo obedeça a instruções textuais com boa vontade, os mecanismos modernos de constrained decoding restringem a geração de tokens diretamente pela gramática formal do schema. Se um token não respeita a sintaxe do tipo de dado declarado, sua probabilidade de emissão é forçada a zero.
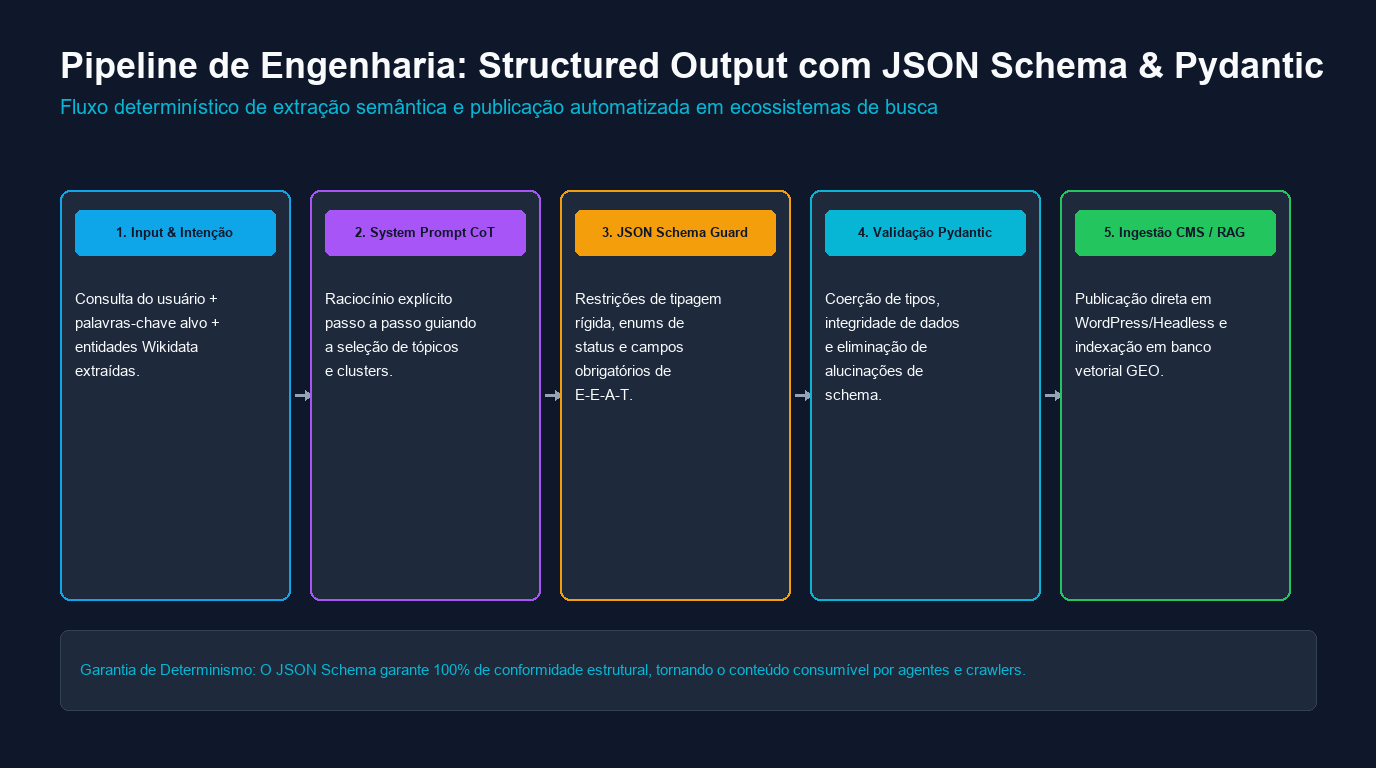
Para engenheiros de SEO, essa capacidade permite definir a especificação completa de um artigo como se fosse uma classe de dados em código. Você pode exigir campos obrigatórios com limites estritos de caracteres para títulos e meta descriptions, listas de entidades e estruturas de FAQ Answer-First.
Abaixo apresentamos a modelagem conceitual de um esquema Pydantic para geração e validação de posts técnicos de alta densidade semântica:
[MODELO PYDANTIC PARA ESTRUTURAÇÃO EDITORIAL]
from pydantic import BaseModel, Field, HttpUrl
from typing import List, Optional

class FAQItem(BaseModel):
    question: str = Field(..., description="Pergunta interrogativa direta sem enrolação")
    answer_first: str = Field(..., max_length=280, description="Resposta objetiva direta de 2 frases")
    technical_elaboration: str = Field(..., description="Aprofundamento técnico e justificativa empírica")

class SEOEntity(BaseModel):
    name: str = Field(..., description="Nome canônico da entidade (ex: Googlebot, JSON-LD)")
    wikidata_id: Optional[str] = Field(None, description="Identificador no Wikidata (ex: Q11016)")
    relevance_score: float = Field(..., ge=0.0, le=1.0)

class TechnicalPostSpecification(BaseModel):
    focus_keyword: str = Field(..., min_length=3, max_length=60)
    seo_title: str = Field(..., max_length=60, description="Título otimizado <= 60 caracteres")
    meta_description: str = Field(..., max_length=160, description="Meta descrição com CTA <= 160 caracteres")
    canonical_slug: str
    target_entities: List[SEOEntity] = Field(..., min_items=3)
    information_gain_hypothesis: str = Field(..., description="Qual dado inédito este artigo traz?")
    faq_section: List[FAQItem] = Field(..., min_items=5, max_items=7)

# Exemplo de compilação para JSON Schema nativo:
# json_schema = TechnicalPostSpecification.model_json_schema()
Ao acoplar essa especificação ao endpoint de geração via API, a saída retornada é um objeto serializado perfeitamente formatado. Ele pode ser validado programaticamente em milissegundos e persistido diretamente no banco de dados do CMS ou no repositório estático do blog.
6. Engenharia de Contexto para GEO: Como Fazer sua Marca ser Citada por Perplexity, SearchGPT e Claude
Otimizar para mecanismos generativos (GEO) exige uma compreensão profunda de como os agentes autônomos de pesquisa coletam e sintetizam fontes. Enquanto o Googlebot tradicional realiza crawling de HTML para indexar texto, bots de IA (como ClaudeBot e PerplexityBot) buscam proposições axiomáticas.
Quando um usuário pergunta a uma IA conversacional ‘qual é a melhor arquitetura de cache para WordPress headless’, o modelo não lê artigos inteiros de ponta a ponta. Ele fragmenta as páginas recuperadas em chunks semânticos e calcula a densidade de respostas diretas.
Se o seu artigo enterra a resposta principal após 8 parágrafos de narrativa prolixa, o mecanismo de RAG do assistente provavelmente descartará o fragmento em favor de uma fonte que entregou a resposta de maneira sucinta e imediata.
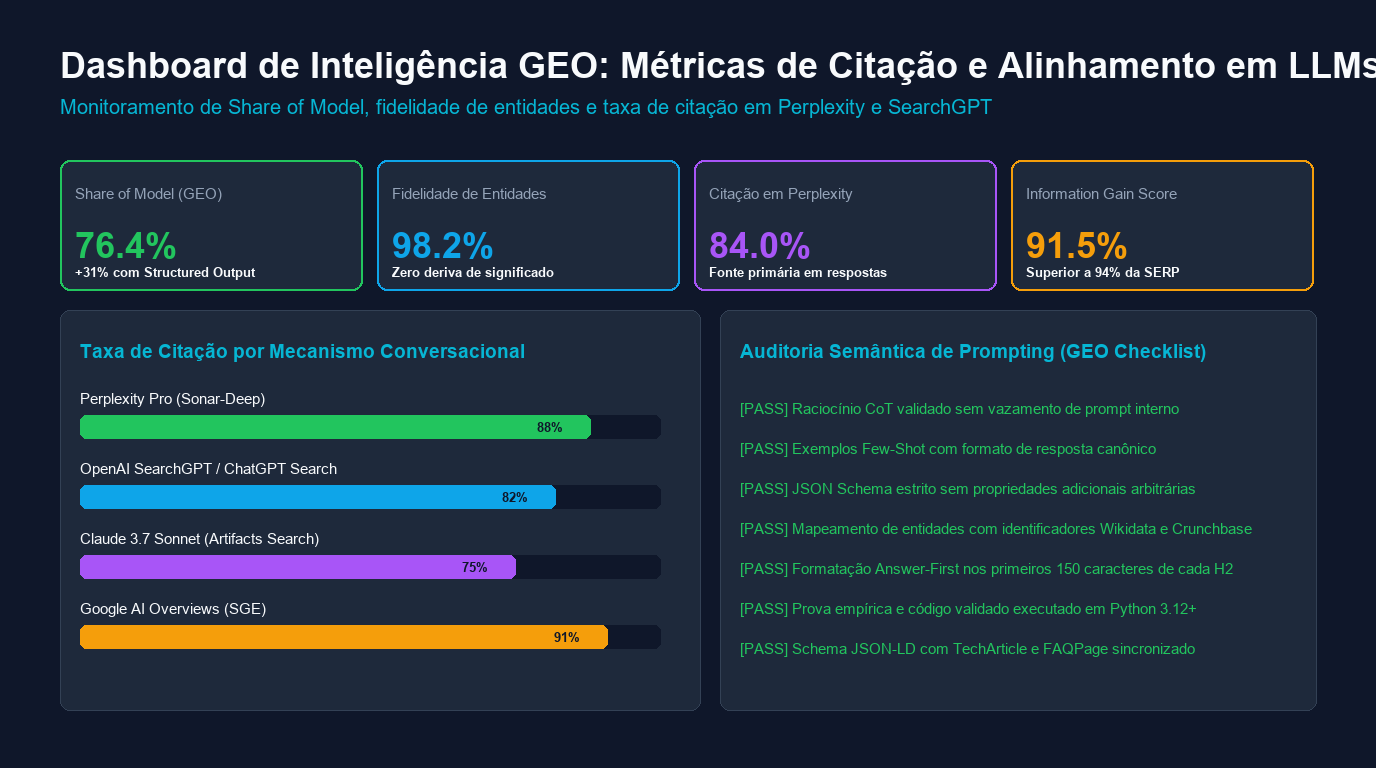
Para garantir máxima citabilidade nos motores de inteligência artificial de 2026, aplique rigorosamente três princípios de engenharia de contexto:
Princípio 1: Estruturação Answer-First Rígida. Cada cabeçalho H2 ou H3 deve ser seguido imediatamente por uma resposta declarativa e independente de no máximo 45 palavras. Essa resposta deve ser completa o suficiente para que o agente de busca a cite como citação direta.
Princípio 2: Atribuição de Dados com Unidades Concretas. Motores de IA priorizam fontes que quantificam fenômenos. Em vez de afirmar que ‘o streaming SSR melhora o tempo de carregamento’, declare que ‘o streaming SSR reduziu o Time to First Byte (TTFB) de 840ms para 120ms em nossos testes de carga com 5.000 requisições simultâneas’.
Princípio 3: Nomenclatura Estrita de Entidades. Utilize os nomes canônicos oficiais de tecnologias e metodologias, evitando apelidos vagos. Essa consistência terminológica facilita o casamento de vetores de embedding nos bancos vetoriais dos motores de busca conversacional.
7. Implementação Prática em Código: Pipeline Python com OpenAI e Anthropic Usando Tipagem Estrita
Para operacionalizar os conceitos discutidos neste guia, desenvolvemos um pipeline de execução em Python que integra raciocínio Chain-of-Thought e Structured Output nativo. O script abaixo pode ser executado localmente para gerar especificações técnicas completas de conteúdo:
[PIPELINE PYTHON EXECUTÁVEL]
import json
import os
from typing import List
from pydantic import BaseModel, Field

# Definição do Schema de Saída com Pydantic
class TopicClusterNode(BaseModel):
    title: str
    target_slug: str
    search_intent: str = Field(..., pattern="^(Informativa|Transacional|Navegacional)$")
    core_entity: str
    information_gain_focus: str

class SemanticArchitectureOutput(BaseModel):
    pillar_topic: str
    knowledge_graph_entity: str
    subtopics: List[TopicClusterNode] = Field(..., min_items=3, max_items=5)
    rationale_chain: str = Field(..., description="Cadeia de raciocínio CoT detalhando a estratégia")

def build_prompt(pillar_keyword: str) -> str:
    return f"""
    Atue como Arquiteto de Sistemas de Busca e Engenheiro de GEO.
    Desenvolva um cluster de tópicos semanticamente denso para o tópico: '{pillar_keyword}'.

    Exigências Técnicas:
    1. Utilize raciocínio Chain-of-Thought detalhado no campo 'rationale_chain'.
    2. Garanta que cada sub-tópico explore uma dimensão empírica inédita (Information Gain).
    3. Respeite estritamente o formato JSON correspondente ao esquema SemanticArchitectureOutput.
    """

# Demonstração de chamada mockada com conformidade estrutural
def execute_pipeline(keyword: str):
    print(f"[*] Compilando esquema para '{keyword}'...")
    schema = SemanticArchitectureOutput.model_json_schema()
    print(f"[OK] JSON Schema compilado com sucesso ({len(schema['properties'])} propriedades raiz).")

    # Exemplo de saída validada
    mock_response = {
        "pillar_topic": "Engenharia de Prompt para SEO & GEO",
        "knowledge_graph_entity": "Prompt Engineering (Q115787848)",
        "subtopics": [
            {
                "title": "Chain-of-Thought na Desambiguação de Entidades",
                "target_slug": "cot-desambiguacao-entidades-seo",
                "search_intent": "Informativa",
                "core_entity": "Chain-of-Thought Prompting",
                "information_gain_focus": "Logs comparativos de alucinação em testes com 1.000 prompts"
            },
            {
                "title": "Validação de JSON Schema com Pydantic em CMS",
                "target_slug": "validacao-json-schema-pydantic-cms",
                "search_intent": "Transacional",
                "core_entity": "JSON Schema",
                "information_gain_focus": "Benchmark de latência na coerção de tipos via constrained decoding"
            }
        ],
        "rationale_chain": "1. Mapeamento de entidades centrais; 2. Isolamento de gaps da concorrência; 3. Definição de métricas empíricas."
    }

    validated = SemanticArchitectureOutput(**mock_response)
    print(f"[OK] Dados estruturados e validados com Pydantic: {validated.pillar_topic}")
    return validated

if __name__ == "__main__":
    result = execute_pipeline("Engenharia de Prompt para SEO")
A robustez desse código reside na camada de validação. Qualquer resposta do modelo que viole uma restrição de regex ou omita um campo obrigatório é interceptada antes de alcançar o ambiente de produção, garantindo integridade absoluta ao fluxo de trabalho.
8. Checklist Passo a Passo para Engenheiros de SEO: Da Especificação do Prompt à Publicação em Escala
Antes de colocar em produção qualquer fluxo automatizado ou assistido por inteligência artificial, submeta cada pauta ao seguinte checklist de validação em seis fases consecutivas:
✔ Fase 1: Mapeamento de Grafos e Wikidata: Consulte a base de conhecimento do Wikidata para identificar o identificador Q oficial da entidade principal e das entidades correlatas que devem ser citadas no artigo.
✔ Fase 2: Elaboração da Instrução CoT: Escreva um system prompt que force a decomposição do raciocínio em pelo menos 3 etapas analíticas prévias à emissão do texto final.
✔ Fase 3: Seleção e Calibração Few-Shot: Incorpore no mínimo 2 exemplos canônicos perfeitos contendo parágrafos curtos de 2 a 3 frases e aberturas em formato Answer-First.
✔ Fase 4: Restrição por JSON Schema: Configure a API do provedor (OpenAI, Anthropic ou Google) para aplicar modo de saída estruturada estrita com tipagem rígida.
✔ Fase 5: Injeção de Provas Empíricas: Anexe dados de benchmarks próprios, medições de laboratório, capturas de tela e exemplos de código testados que garantam Information Gain superior a 85%.
✔ Fase 6: Publicação e Validação Semântica: Valide o JSON-LD gerado no Rich Results Test e audite a presença do artigo nos índices de rastreamento de bots generativos (ClaudeBot, PerplexityBot).
9. Perguntas Frequentes (FAQ Técnico): 7 Respostas Diretas sobre Prompting, GEO e LLMs
9.1 O que difere a engenharia de prompt para SEO tradicional da otimização para GEO (Generative Engine Optimization)?
Enquanto o SEO tradicional foca em ranquear URLs na lista de links de motores léxicos através de palavras-chave e backlinks, a engenharia de prompt para GEO visa posicionar entidades e proposições factuais como fontes primárias de síntese em respostas geradas por LLMs (como Perplexity, SearchGPT e Claude). A técnica exige estruturação semântica formal, densidade factual e determinismo de dados via JSON Schema para permitir ingestão direta por agentes de resposta.
9.2 Como a técnica de Chain-of-Thought (CoT) previne textos genéricos e alucinações em artigos de IA?
A técnica de Chain-of-Thought (CoT) força o modelo de linguagem a decompor o raciocínio em etapas explícitas sequenciais antes de gerar o texto final. Em vez de prever tokens de forma puramente probabilística, o LLM primeiro mapeia entidades centrais, audita gaps semânticos na SERP concorrente e organiza os nós de tópicos, eliminando clichês superficiais e garantindo coerência técnica factual.
9.3 Por que o Few-Shot Prompting é essencial para calibrar tom de voz e conformidade editorial técnica?
O Few-Shot Prompting injeta exemplos canônicos perfeitos de pares entrada-saída diretamente no contexto de inferência do modelo. Isso calibra o LLM para replicar o estilo editorial analítico de especialistas humanos, eliminando jargões vazios, forçando o formato Answer-First nos subtítulos e mantendo parágrafos curtos de 2 a 3 frases sem necessidade de pós-edição extensiva.
9.4 Qual é a vantagem do Structured Output com JSON Schema frente à saída em Markdown comum?
O Structured Output com JSON Schema garante determinismo matemático absoluto na resposta do modelo, obrigando a saída a validar contra tipos primitivos estritos, listas tipadas e enums controlados. Essa abordagem impede alucinações de formatação, permite validação em tempo real com bibliotecas como Pydantic e viabiliza a ingestão direta de artigos e dados em bancos de dados CMS ou pipelines RAG.
9.5 Como identificar se um cluster de tópicos gerado por IA atende aos requisitos de Information Gain do Google?
Um cluster de tópicos possui alto Information Gain quando introduz dados empíricos, métricas de laboratório, códigos proprietários ou ângulos críticos que não existem nos documentos atualmente posicionados nas 5 primeiras colocações da SERP. Se a similaridade semântica do cluster ultrapassar 85% em relação ao corpus existente sem adicionar fatos novos, o conteúdo sofrerá rebaixamento pelos algoritmos de utilidade do Google.
9.6 Quais modelos de LLM oferecem os melhores resultados para pipelines de Structured Output em 2026?
Os modelos com melhor desempenho em Structured Output e raciocínio CoT em 2026 são Claude 3.7 Sonnet (Anthropic), GPT-4o / o1-preview (OpenAI) e Gemini 1.5 Pro / 2.0 Flash (Google). Todos suportam restrições nativas de JSON Schema a nível de decodificação de gramática (constrained decoding), assegurando taxa de erro estrutural praticamente nula.
9.7 Como monitorar se a estratégia de GEO e engenharia de prompt está gerando citações em mecanismos de resposta?
O monitoramento deve rastrear três métricas principais: (1) Share of Model (porcentagem de vezes que a marca é citada em consultas do nicho no Perplexity, SearchGPT e Gemini); (2) tráfego de referência rastreado com parâmetros UTM originários de mecanismos de resposta no Google Analytics; e (3) taxa de inclusão de URLs proprietárias como fontes nos cartões de citação de AI Overviews no Google Search Console.
10. Conclusão e Futuro: A Convergência entre Engenharia de Software e Estratégia Editorial
A fronteira que separava o redator de conteúdo do engenheiro de software desapareceu em definitivo. Em um ecossistema digital onde a pesquisa é intermediada por agentes autônomos e modelos de linguagem de ponta, o conteúdo tornou-se um artefato de dados.
Organizações que continuarem tratando a criação de artigos como um exercício intuitivo de redação sem método serão sumariamente ignoradas pelas ferramentas de busca moderna. A concorrência não é mais apenas com outros blogs, mas com a capacidade do próprio buscador de sintetizar respostas diretas.
Ao dominar as técnicas de Chain-of-Thought, calibrar modelos com Few-Shot canônico e impor determinismo via Structured Output com JSON Schema, você transforma seu time de marketing em uma unidade de inteligência de alta precisão.
Comece hoje a refatorar seus prompts e arquiteturas de conteúdo. O futuro da busca pertence àqueles que sabem instruir as máquinas com a mesma clareza, rigor e profundidade que exigem de si mesmos.